정확도 70%에 멈춘 기업용 생성형 AI, 인포시즈는 왜 "그래프"에서 답을 찾았나
개요
| 항목 | 내용 |
|---|---|
| 주제 | 기업 데이터의 파편화와 생성형 AI 환각 문제를 그래프 기술·온톨로지로 해결하는 인포시즈(INFOCZ)의 실전 사례 |
| 핵심 관점 | "모델을 더 똑똑하게 만드는 것"이 아니라 "데이터의 관계를 먼저 구조화하는 것"이 정확도의 상한을 바꾼다 |
| 핵심 키워드 | Vector RAG 한계 · 그래프 기술 · 온톨로지 레이어 · OQL/DSL · FDE(Forward Deployed Engineer) · 그래프 기반 이상탐지 · 도면 인식 · 시뮬레이션 에이전트 |
| 출처 | EO Korea 다큐멘터리 「정확도 70%에 머문 AI, 그래프 기술로 근본부터 해결한다」(24:09, 대표 포함 구성원 6인 인터뷰) |
핵심 메시지 3가지
① 정확도 70%의 원인은 모델이 아니라 "흩어진 데이터"다
생성형 AI를 도입한 기업들이 겪는 가장 기본적인 실패는 검색 자체가 안 되는 문제입니다. 원인은 기업 안의 데이터가 흩어져 있거나 파편화되어 제대로 활용되지 못하기 때문입니다. 2024~2025년 크게 유행했던 벡터(Vector RAG) 방식으로도 이 문제는 해결되지 않았고, 환각은 남았고 정확도는 약 70% 선에 머물렀습니다.
② 해법은 "모으고 → 연결하고 → 그 위에서 경로 있게 답하는" 구조다
환각을 없애는 길은 흩어진 데이터를 잘 모으고 연결해서 분석하는 것이고, 그게 바로 그래프 기술입니다. 인포시즈는 여기에 온톨로지 레이어를 중간 단계로 넣어, 복잡한 개념을 단순화·추상화한 뒤 이미 찾아가는 길이 정해진 상태에서 답변을 생성합니다.
③ 기술의 소유권을 지킨 결정이 회사를 만들었다
대기업 대규모 프로젝트 수주 직전, 솔루션 소유권 전체를 넘기라는 요구를 받고 십몇 일을 고민한 끝에 계약을 포기했습니다. 재정적 임팩트는 컸지만, 이 결정이 "자체 기술력을 보유한다"는 인포시즈의 기본 모태가 되었습니다.
1. 문제 진단 — 왜 기업 AI는 검색 한 번 제대로 못 하는가
 (https://)
| 단계 | 상황 | 결과 |
|---|---|---|
| ① 도입 | 많은 기업이 생성형 AI를 도입 | 기대와 다른 현장 |
| ② 증상 | 가장 기본적인 검색 기능조차 안 됨 | 사내 데이터 활용 불가 |
| ③ 원인 | 데이터가 흩어져 있고 파편화됨 | 제대로 활용되지 못함 |
| ①차 시도 | 벡터(Vector RAG) 로 유사 문서 검색 | 24~25년 유행·적용 |
| ② 잔존 문제 | 환각 미해결, 정확도 약 70% 정체 | 엔터프라이즈 신뢰 수준 미달 |
"24년에서 25년 사이에 크게 유행을 하고 기업들의 적용을 해왔음에도 불구하고 아직까지도 이런 생성형 AI의 환각에 대한 문제가 해결되지 않고 정확도가 약 70% 정도 선에 머물러 있습니다."
여기서 핵심은 정형/비정형의 비대칭입니다. 정형 데이터는 형태가 정해져 있어 기계가 다루기 유리하지만, 비정형(이메일·메시지·계약서·도면)은 "그 외의 전부"라 다룰 방법이 마땅치 않습니다. 그래서 업계는 보통 관련된 걸 찾아서 넣어주는 방식, 즉 벡터 검색에 의존해 왔습니다.
2. 해법의 구조 — 온톨로지 레이어가 '네비게이션'이 되는 순간
인포시즈의 접근은 벡터 검색에서 한 단계 더 나가는 것입니다.
① 문서들이 다루는 개념·대상을 모두 추출
↓
② 같은 개념을 다루는 여러 문서가 한데 모이게 구성
↓
③ 온톨로지 레이어 = 네비게이션의 길/건물/도로처럼 복잡한 개념을 단순화·추상화
↓
④ 그 위에서 먼저 길을 찾고, 찾아진 경로를 기반으로 답변 생성
↓
⑤ 정확도 상승 + "어떤 경로로 나온 답인가" 보이는 설명가능성 + 운영 용이성
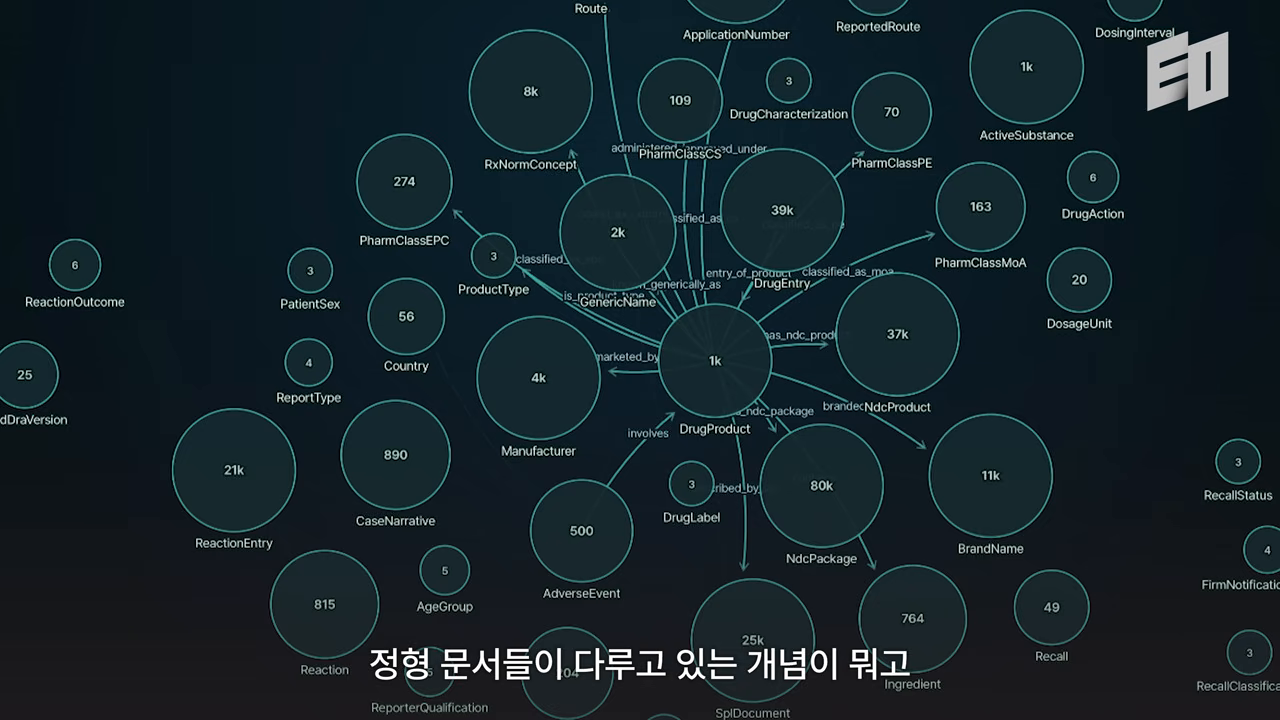
이 구조가 실제로 화면에 어떻게 담기는지, 온톨로지 탐색 UI에는 타입(종류) 105종 / 객체 46 · 관계 59 라는 숫자가 그대로 표시되어 있습니다. 개념을 추상화한 결과물이 곧바로 운영 도구가 되는 셈입니다.
정확도를 올리는 역발상: AI의 자유도를 줄인다
"절대로 틀리면 안 된다, 정확도가 100% 나와야 한다"는 고객사 프로젝트에서 내린 결론은 이렇습니다.
| 판단 | 내용 |
|---|---|
| 관찰 | 자유도가 많다는 건 실수할 일이 많아진다는 것 |
| 결정 | AI에 자유도를 덜 주자 |
| 도구 | DSL(도메인에 특화된 언어) |
| 추가 장치 | OQL 중간 계층 — 사람이 이해하기 어려운 복잡한 SQL을 LLM도 이해하기 쉽게 중재 |
| 효과 | 환각률을 거의 제로에 가깝게 낮춤 |
그리고 이 모든 것의 전제 조건이 하나 있습니다.
"결국 에이전트 성능에 진짜 많이 영향을 주는 게 데이터 퀄리티예요. 데이터 정제를 잘하려면 업무 이해도가 굉장히 좋아야 되거든요. 현업과 엔지니어들이 거의 한 몸처럼 일을 해야 AI한테 잘 전달할 수 있는 형태의 정제를 할 수가 있어요."
3. 실증된 성과 3가지 — 그래프가 "돈과 시간"으로 환산된 지점
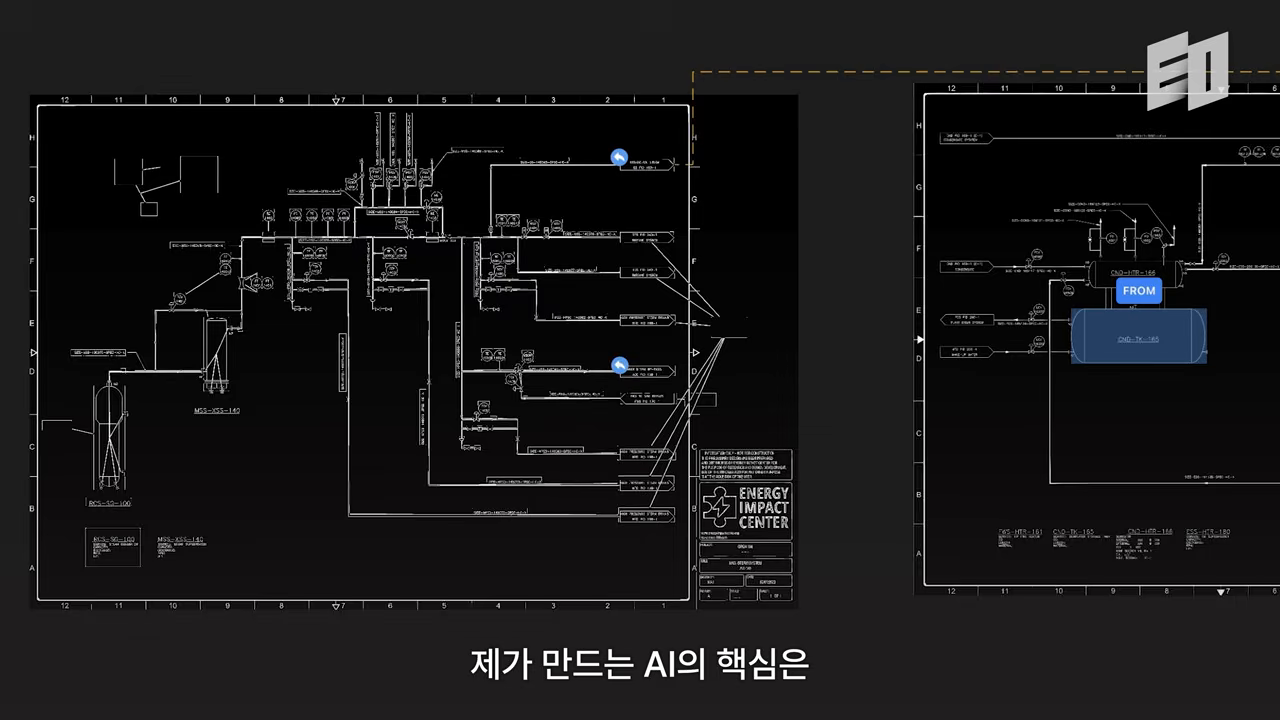
성과 ① 도면 인식 — 6개월 미해결을 깬 첫 계약
| 항목 | 수치 |
|---|---|
| 고객사(S사) 보유 도면 | 약 3,000장 |
| 고객사가 인식을 못 하고 찾던 기간 | 6개월 이상 |
| 인포시즈의 당시 비전 기술 보유 상태 | 없음(0) |
| 사람 수작업 처리 시간 | 장당 최소 8시간 이상 |
| 자동 인식 처리 시간 | 5분 이내 |
| 난이도 | 복잡한 도면 연결관계 복원은 학계에서도 풀리지 않은 난제, 거의 최초 상용 수준, 서울대학교 공동연구 |
당시 인력도 없던 비전 영역을 논문부터 뒤져 만들어냈고, 결과는 이랬습니다.
"전 세계적으로 가장 큰 회사들과 했음에도 불구하고 그래프 기술을 활용하는 기술을 보고 아주 새로운 방법이라고 생각하고 대기업에서 저희를 선택하는 그런 계기가 됐었습니다."
성과 ② 그래프 기반 보안 — "규칙 없음"이 패러다임의 차이
| 구분 | 기존 보안 제품 | 인포시즈 제품 |
|---|---|---|
| 탐지 기준 | 알려진 공격 패턴을 규칙으로 등록 | 규칙을 애초에 상정하지 않음 |
| 동작 방식 | 규칙 위반 시 차단·알람 | 평상시 업무에서 크게 벗어나면 자동 알람 |
| 2차 처리 | 분석가 판단 | LLM이 위협 여부 필터링 후 보안 분석가에게 전달 |
| 잡을 수 있는 공격 | 순간 대량 유출형 | 30일 잠복·소량씩 지속 유출형 |
| 실증 | — | 시총 상위권 반도체 회사에서 아예 잡지 못했던 위협 탐지 |
"한 시간 동안의 로그를 봐서는 알 수가 없고 장기간에 걸친 로그를 그래프 형태로 인식해야지만 잡을 수 있는 그런 공격 패턴입니다. 그래프 기반 이상 탐지를 대규모 엔터프라이즈에서 적용해서 실증한 사례는 국내에서는 없는 걸로 알고 있고요."
성과 ③ 시뮬레이션 에이전트 — 손익계산서까지 닿는 AI
S사에는 제품 시뮬레이션 에이전트가 만들어졌습니다. 무엇을 많이 만들고 무엇을 적게 만드는지, 원가는 어떻게 되는지를 시뮬레이션하는 에이전트입니다.
- 생산량·원가 시뮬레이션 → 영업이익에 기여 → 주가에 영향
- 공정 데이터가 온톨로지화되어 의미론적으로 연결되면 하나의 큰 시뮬레이션이 가능해집니다.
- 다음 분기점은 비정형 문서 + 도면을 연결하고 나아가 시뮬레이션까지 가능한 설계 에이전트 — 피지컬 세계에 가장 가까운 프로젝트입니다.
4. 2026 에이전트 시대 — 왜 지금 그래프와 온톨로지인가
| 시점 | 에이전트 도입 규모 |
|---|---|
| 2026년까지 | 기업당 10~20개 수준 |
| 올 하반기~내년 초 | 수백 개, 수천 개로 공격적 확대 예상 |
| 이후 | 기업의 거의 모든 업무를 에이전트가 수행하는 시대 |
문제는 개수가 아니라 관리와 정보 전달입니다. 에이전트가 수백 개가 되면 "어떤 정보가 제대로 전달되는가"가 기업의 핵심 리스크가 됩니다.
| 영역 | 현재 상태 | 필요한 것 |
|---|---|---|
| 비용 | 온톨로지 구축에 돈 많은 대기업만 접근 | 구축 과정의 상당 부분 자동화 |
| 로봇 | 전시회 시연 대비 실제 현장 투입 10분의 1도 안 됨 | 현장에 어떤 일을 해야 하는지 가이드·정보 전달 |
| 공통 | 에이전트·로봇이 제대로 동작 못 함 | 기업 정보와 구조의 전달·활용·관리 = 그래프와 온톨로지 |
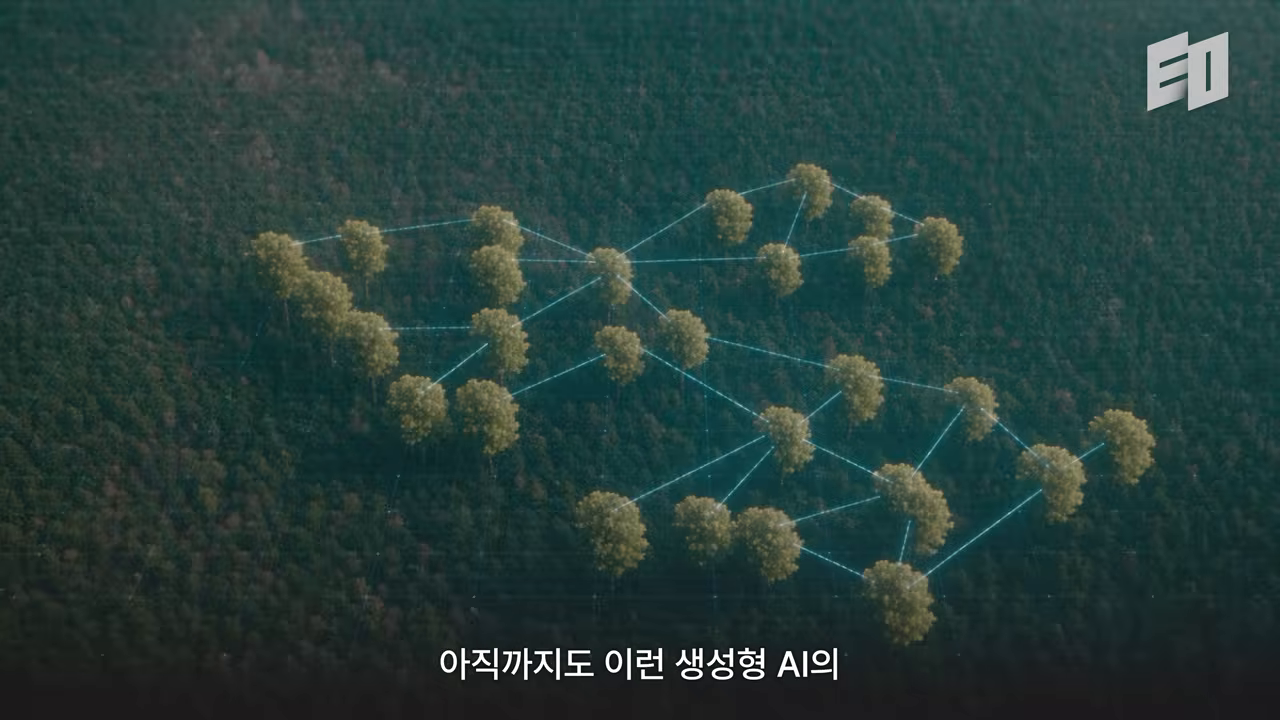
연결의 힘은 영화 아바타의 나비족 비유로 설명됩니다. 본인들의 힘을 최대한 끌어내기 위해 서로를 둘러싼 모든 것과 연결하는 장면 — AI 시대에 주변 모든 것이 네트워크 형태로 연결되는 것이 큰 힘을 발휘하는 전형적 예라는 것이 이 회사의 출발 논리입니다.
5. 비즈니스의 변곡점 — 투자, 그리고 포기한 계약
| 시점 | 사건 | 의미 |
|---|---|---|
| 출발 | 보안 전문 기업으로 시작 | IT에서 난이도 최상위 + 엄청난 빅데이터 영역 |
| 전환 | "인식하지 못하던 정보들이 연결된다면 새로운 인사이트가 생기지 않을까" | 그 답이 그래프 이론·그래프 기술 |
| 2025년 넘어 | Vector RAG 이후의 대안 기술로 그래프가 세계적으로 부상 | 문의 급증, 그래프 탐색 요청 |
| 올해 | 국내 최대 대형 투자사로부터 투자 유치 (화면 자막: 인포시즈 130억 투자 유치) | 기술 노선의 외부 검증 |
| 그 사이 | 모 대기업 대규모 프로젝트 수주 → 솔루션 소유권 전체 양도 요구 → 십몇 일 고민 → 계약 포기 | 재정적 타격, 그러나 자체 기술력 보유가 회사의 모태가 됨 |
"한 번은 프로젝트 비용을 받기 때문에 좋지만, 우리 기술 자체에 대한 축적을 찾기가 굉장히 어렵다라는 생각에서 그 프로젝트를 포기하게 됐습니다."
6. 관점 포인트 — 실무자가 짚어야 할 6가지
- 정확도는 모델 문제가 아니라 데이터 구조 문제다. 검색이 안 되는 원인을 프롬프트에서 찾으면 70%에서 멈춥니다.
- 벡터 RAG는 "관련된 걸 찾아 넣어주는" 단계다. 그 다음 단계는 개념과 대상을 추출해 문서끼리 묶는 일입니다.
- AI의 자유도를 줄여라. DSL·OQL처럼 도메인 특화 언어로 선택지를 좁히는 것이 정확도에 직결됩니다.
- 경로가 보이는 답변만 운영할 수 있다. 온톨로지의 진짜 가치는 정확도보다 "어떤 경로로 나왔는지" 보이는 설명가능성에 있습니다.
- 데이터 퀄리티는 현업 이해도의 함수다. 현업과 엔지니어가 한 몸처럼 붙지 않으면 정제된 데이터가 나오지 않습니다.
- 기술 소유권은 협상 항목이 아니다. 소유권 양도 요구를 거절한 결정이 결과적으로 회사의 자산이 되었습니다.
그리고 FDE라는 새 직무
| 항목 | 내용 |
|---|---|
| 정의 | Forward Deployed Engineer(전방 배치 엔지니어) — 고객 문제를 현장에 직접 들어가 해결 |
| 업무 범위 | 문제 발굴부터 전부 직접, 프로젝트 전 현업 워크숍 진행 |
| 요구 역량 | 해당 도메인의 전문가 수준 이해도 |
| 수요 증가 이유 | 대기업은 데이터를 내부에서만 정제해야 하고 외부 유출 불가, 인하우스 인력으로는 해결 불가 |
| 작업 속도 | 솔루션 기반 → 몇 시간 만에 세팅 완료 후 즉시 시연 → 신뢰 확보 |
| 보안 전제 | 다루는 데이터가 산업적·국가적으로 중요 → 보안이 최우선 |
7. 최종 핵심 정리
확인해야 할 핵심 질문
- 우리 회사 AI가 검색에 실패하는 이유는 모델인가, 파편화된 데이터인가?
- 우리는 벡터 검색에 갇혀 있진 않은가? 개념 단위로 문서를 묶는 중간 레이어가 있는가?
- 답변의 경로를 보여줄 수 있는가? 없다면 운영·개선도 불가능하다.
- LLM에 불필요하게 넓은 자유도를 주고 있지 않은가? DSL·중간 쿼리 언어로 좁힐 지점은 어디인가?
- 데이터 정제를 현업 이해도로 하고 있는가, 엔지니어 추측으로 하고 있는가?
- 에이전트가 수백 개가 되는 시점에 정보 전달·관리 구조를 미리 만들어 둘 것인가?
한 줄 요약: 정확도 70%의 벽은 더 좋은 모델이 아니라, 흩어진 데이터를 그래프로 연결하고 온톨로지로 길을 만든 뒤 AI의 자유도를 줄이는 데서 넘어선다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.