4개월 만에 10억 → 20억 달러, Mercor의 'RL Environment' 데이터를 숫자로 분해한다
핵심 발견: 모델 성능의 병목은 알고리즘이 아니라 '경제 전체의 world·app·task 분포'를 얼마나 복제했는가로 이동했고, 그 복제 작업에 투입된 전문가 시간이 2년 만에 분기당 2천 시간에서 250만 시간으로 늘었다.
1. 개요
| 항목 | 내용 |
|---|---|
| 주제 | RL Environments & Data — 프런티어 지능을 훈련시키는 환경·데이터 구축 (Brendan Foody, Mercor / Sequoia Sovereign AI 세션) |
| 핵심 관점 | 데이터는 '라벨링 비용'이 아니라 모델이 도달할 수 없는 경계를 측정하는 인프라다 |
| 핵심 키워드 | RL Environment · Worlds / Apps / Tasks · RLVR · Verifier & Rubric · Expert Hours · APEX-Agents · GDPVal · Off-the-shelf Data |
| 분석 대상 | 발표 영상 26:22 / 발화 세그먼트 181건 / 화면 프레임 110건 |
2. 핵심 메시지 3가지
① 매출 곡선이 말해주는 것: 데이터는 이제 '가장 차별적인 자산'
발표冒頭에서 사회자는 Mercor의 연간 환산 매출(run rate)이 지난 4개월 남짓 사이에 10억 달러에서 20억 달러로 늘었다고 짚는다. 발표자는 이 성장의 이유를 애플리케이션 기업들의 AI 전략 3대 축에서 찾는다 — compute, algorithms/researchers, 그리고 직접 구축하는 data set. 그리고 "데이터가 종종 가장 차별적인 요소(data is often the most differentiating factor)"가 된다.
② 데이터 시장의 축이 3단계로 이동했다
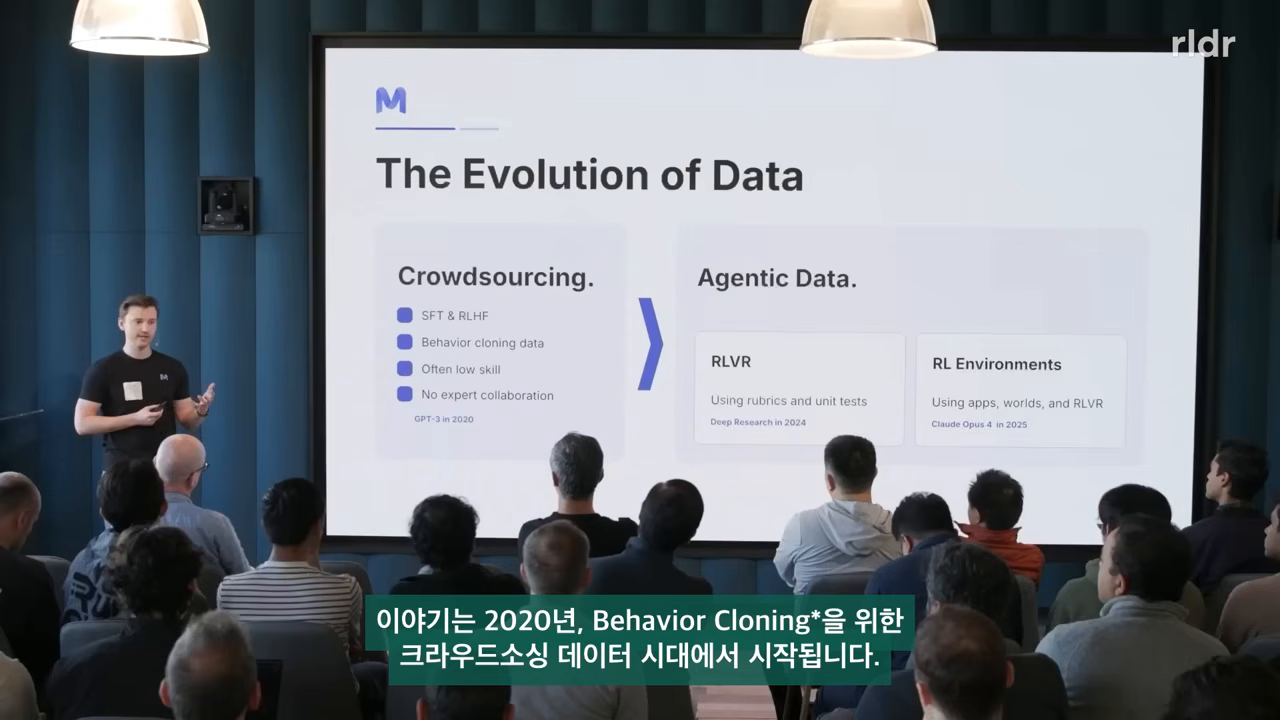
2020년 크라우드소싱 → 2024년 RLVR/Deep Research → 2025년 RL Environments. 저숙련 라벨링 시대가 끝나고, 소프트웨어 엔지니어·변호사·의사·뱅커가 팀으로 프런티어 eval과 환경을 만드는 시대로 넘어갔다.
③ 사람만이 '경계 너머'를 채점할 수 있다
모델에게 슬라이드 덱을 만들게 하면 자기 숙제를 스스로 채점하는 셈이 된다. 그래서 rubric을 만드는 주체는 사람이어야 하며, 이 병목이 곧 Mercor의 사업 구조 그 자체다.
3. 데이터 시장의 3단계 진화 — 무엇이 바뀔까
| 단계 | 방식 | 특징 | 시점 |
|---|---|---|---|
| Crowdsourcing | SFT & RLHF, Behavior cloning data | Often low skill / No expert collaboration | GPT-3 in 2020 |
| Agentic Data — RLVR | Using rubrics and unit tests | 전문가 기반 eval 착수 | Deep Research in 2024 |
| Agentic Data — RL Environments | Using apps, worlds, and RLVR | rich apps·worlds로 도구 사용법까지 학습 | Claude Opus 4 in 2025 |
Mercor의 첫 대형 프로젝트가 Deep Research였고, 이후 모든 프런티어 랩과 Harvey, Sierra, Cognition, Ramp 등 애플리케이션 계층 기업의 주요 agentic 데이터 벤더로 확장됐다.
4. RL Environment의 구성 3요소 — Worlds / Apps / Tasks
| 구성 | 정의 | 세부 |
|---|---|---|
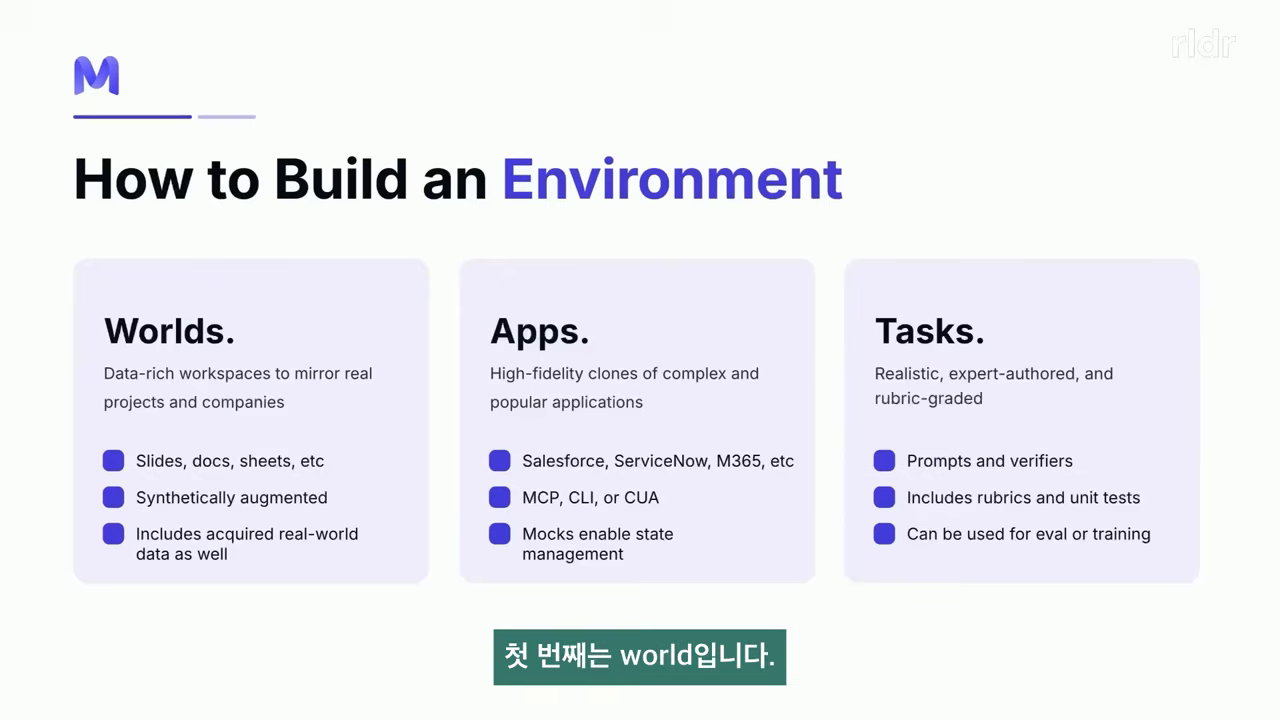
| ① Worlds | 실제 프로젝트·회사를 미러링하는 data-rich workspace | Slides, docs, sheets 등 / 합성 증강 / 실제 확보 데이터 포함 |
| ② Apps | 복잡·대중 애플리케이션의 고충실도 복제 | Salesforce, ServiceNow, M365 등 / MCP, CLI, CUA로 상호작용 / Mock으로 상태 관리 |
| ③ Tasks | 현실적이고 전문가가 작성하며 rubric으로 채점되는 과제 | Prompts & verifiers / rubrics·unit tests / eval과 training 겸용 |
병목의 논리는 명확하다. Claude로 노트북에서 하는 일을 전부 자동화하려면 경제 전체의 모든 world·app·task 분포를 커버해야 한다. GDPVal만 해도 노동통계국 기준 205개 도메인인데, 그 직업마다 대응하는 앱·시나리오·과제를 모두 만들어야 한다.
5. 병목의 정량 증거 — Expert Hours 그래프
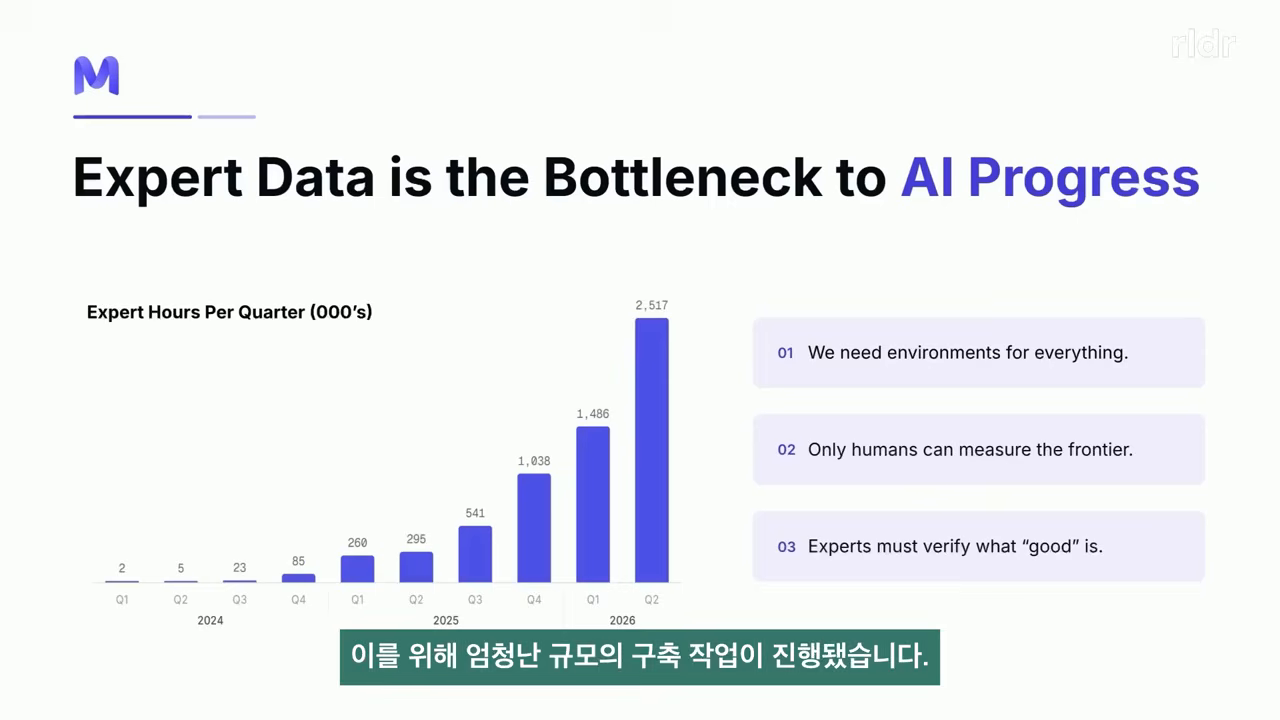
슬라이드 제목은 그대로 "Expert Data is the Bottleneck to AI Progress"다. 'Expert Hours Per Quarter (000's)' 그래프 수치:
| 연도 | Q1 | Q2 | Q3 | Q4 |
|---|---|---|---|---|
| 2024 | 2 | 5 | 23 | 85 |
| 2025 | 260 | 295 | 541 | 1,038 |
| 2026 | 1,486 | 2,517 | — | — |
- 단위 환산: 2026년 Q2 = 2,517천 시간 ≈ 250만 시간 (발표 자막 "2분기에만 250만 시간")
- 2024 Q1(2) → 2026 Q2(2,517) 증가 배율 = 1,258.5배
- 2025 Q4(1,038) → 2026 Q2(2,517) = +1,479천 시간, 약 2.42배
슬라이드가 정리한 3원칙: 01 We need environments for everything. / 02 Only humans can measure the frontier. / 03 Experts must verify what "good" is.
6. 실제 사례 — Sample Legal Environment과 APEX-Agents 학습 효과
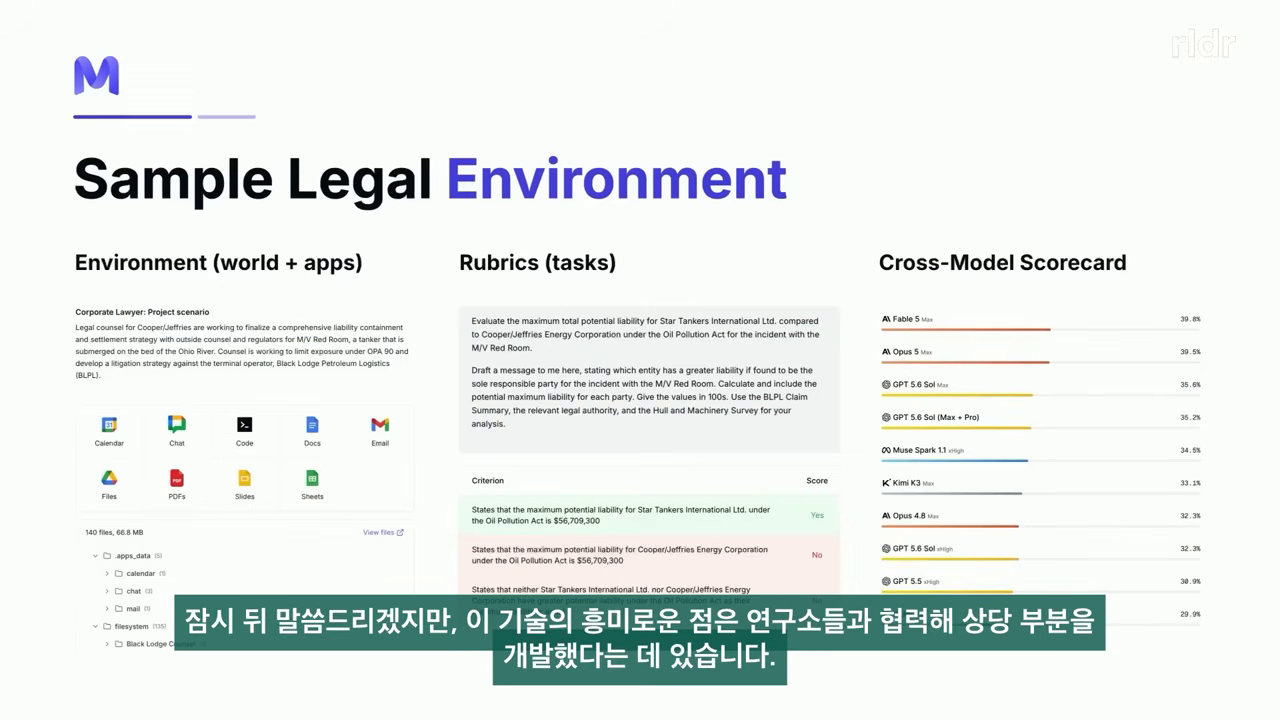
사례 A: 법률 환경 (Latham & Watkins)
| 항목 | 내용 |
|---|---|
| 시나리오 작성자 | Latham & Watkins 등 최상위 로펌 변호사 (실제 담당 프로젝트 기반) |
| Data room 규모 | 140 files / 66.8 MB, 메시지·이메일·파일·파일 크까지 구성 |
| 앱 | Google Workspace 복제본 (Calendar·Chat·Code·Docs·Email·Files·PDFs·Slides·Sheets) |
| 과제 | Oil Pollution Act상 Star Tankers International Ltd. vs Cooper/Jeffries Energy Corp.의 최대 잠재 책임 산정 |
| 책임 한도 후보 | $26,700,000 / $36,700,000 |
| Cross-Model Scorecard | Fable 5 39.8% · Opus 5 39.5% · GPT 5.6 Sol 35.6% · Muse Spark 1.1 34.5% · Kimi K3 33.1% · Opus 4.8 32.3% · GPT 5.5 30.9% |
사례 B: APEX-Agents post-training (GLM-4.7 → GLM-4.7 + RL)
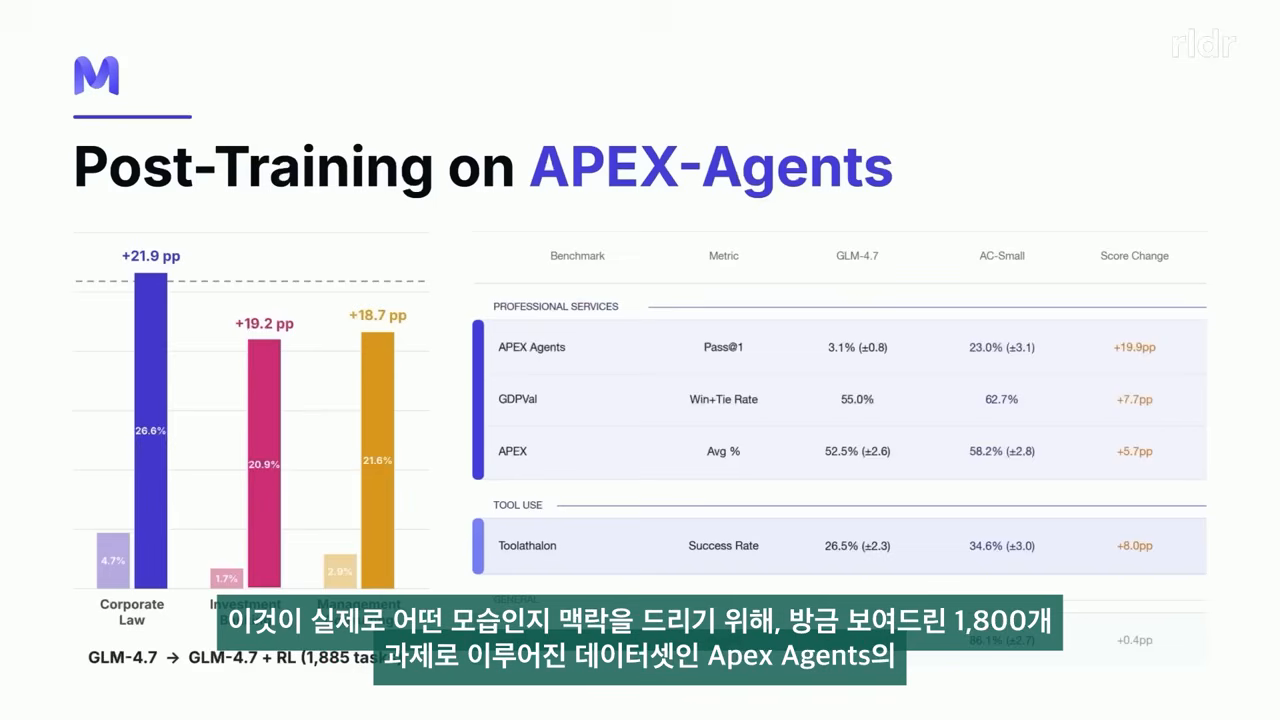
과제 수 약 1,800개(슬라이드 각주 1,885 tasks), 컴퓨팅 비용 about $500K.
| 벤치마크 | 지표 | GLM-4.7 | RL 후 | 변화 |
|---|---|---|---|---|
| APEX Agents | Pass@1 | 3.1%(±0.8) | 23.0%(±3.1) | +19.9pp |
| GDPVal | Win+Tie Rate | 55.0% | 62.7% | +7.7pp |
| APEX | Avg % | 52.5%(±2.6) | 58.2%(±2.8) | +5.7pp |
| Toolathlon | Success Rate | 26.5%(±2.3) | 34.6%(±3.0) | +8.0pp |
직무별 상승: Corporate Law 4.7% → 26.6% (+21.9pp), Investment Banking 1.7% → 20.9% (+19.2pp), Management Consulting 2.9% → 21.6% (+18.7pp).
핵심은 일반화다. data room이 포함된 APEX Agents 데이터만 줬는데도 data room이 없는 GDPVal·APEX에서 상승이 나왔고, 다른 벤치마크에서도 nominal gains이 관측됐다. 같은 실험을 Kimi K3로 재진행 중이며 GLM 5.2·Kimi K3가 리더보드에 오른 것은 애플리케이션 기업의 프런티어 도달 가능성을 넓힌 신호로 제시됐다.
7. 가격·품질·미래 — 사업 모델의 3개 축
① 데이터 판매 3가지 방식
| 방식 | 내용 | 규모 |
|---|---|---|
| By task (가장 일반적) | "법률 env 데이터 형태가 좋으니 과제당 $2,000을 내고 확장하겠다" | 일부 프런티어 랩은 월 50,000 tasks 구매 |
| Off-the-shelf data | 자체 데이터셋에 수억 달러(hundreds of millions) 투자, 다수 고객 재판매 | 신규 neo lab들이 이쪽으로 이동 — 10개 랩이 각자 만들 이유 없음 |
| Experts (hourly) | 고객 스스로 전문가 조직 (Harvey가 이 방식으로 시작) | 비중 축소 중 |
② 원가·가격 구조
- 과제 가격 범위: $50 ~ $10,000
- 원가 산식: 10시간 × $150/시간 = $1,500 cost basis → 차별성·프런티어도에 따라 마진 얹기
- 지불 의사 상한 예시: Nvidia는 프런티어 오픈소스 모델을 위해 10억 달러 수준을 낼 수 있다
- 품질의 두 정의: ① realism(실제 분포 반영) + ② accuracy of verifiers(채점 정확도)
- 검증 기법: trajectory analysis — 개선 대상 모델로 10개 trajectory를 rollout하고, agentic QC + 사람 리뷰로 점수 정합성 확인
③ 다음 병목 2가지
| 변화 | 현재 | 목표 |
|---|---|---|
| Ultra long horizon | 에이전트는 10시간 초과 작업을 거의 학습하지 못함 | 사람이 100시간, 1,000시간 걸리는 작업으로 확장 |
| Virtual coworkers | 업무 중 타인과 상호작용이 필요한 비율 = 응답자 대다수 60~70% | 이를 측정하는 eval 비율 = 약 1% → real-to-sim gap |
합성 데이터 오해 바로잡기: RLVR 자체가 합성 데이터에 대한 베팅이다(사람이 SFT를 쓰는 대신 모델 trajectory를 rollout해 채점). 또한 환경·데이터룸 populate에는 Claude/ChatGPT가 대규모로 쓰인다. 다만 task creation은 사람이 가장 필수적인 구간이다 — 자기 실수의 rubric을 스스로 쓰게 하면 절반은 맞고 절반은 틀리며, 그 노이즈는 학습에 사용 불가. 예외는 수학(깨끗한 시뮬레이션), 코드, 그리고 Kimi K3보다 약한 모델을 증류할 때뿐이다. 사이버 방어는 attacker/defender 에이전트 구성이 가능해 verifier의 사람 의존도가 낮은 영역으로 지목됐다.
베이스 모델 한계 판별법: pass@1에서 실패하되 pass@16에서 1~2회 성공하면 학습이 효과적으로 일어난다. 16개를 돌려도 전부 틀리면 "hopeless"에 가깝다.
8. 관점 포인트
- 매출 2배보다 중요한 신호 — 4개월 만에 10억→20억 달러는 '데이터 구매 예산'이 랩 단위에서 애플리케이션 단위로 확산 중임을 뜻한다.
- 환경 3요소 중 진입장벽이 높은 건 Apps — Salesforce·ServiceNow·M365를 MCP/CLI/CUA로 복제하고 Mock으로 상태까지 관리해야 한다.
- rubric은 비용이 아니라 IP — reward hacking을 피하면서 100개 trajectory 점수를 모두 정확히 내는 verifier 구축이 연구의 중심이다.
- 커스텀 vs 오프더셸의 선택 기준 — 경쟁 우위를 지키려는 기업은 siloed·배타적 전담 팀으로 자신이 소유하는 데이터셋을 만들고, 인프라·탤런트 네트워크의 규모경제는 파트너에게서 가져간다.
- 일반화 지표로 데이터를 평가하라 — APEX Agents 학습 후 GDPVal +7.7pp처럼, 준 데이터셋 밖 벤치마크 상승이 진짜 가치의 증거다.
- eval 설계 공백 = 기회 — 상호작용 측정 1% 대 실제 업무 60~70% 격차는 버티컬 eval 스타트업의 빈 공간이다.
9. 최종 핵심 정리
확인해야 할 핵심 질문
- 우리 제품의 AI 전략 3축(compute / algorithm / data) 중 data에 배정된 예산과 인력은 있는가?
- 우리가 자동화하려는 업무의 world·app·task 분포는 실제 경제 분포를 얼마나 커버하는가?
- verifier는 realism과 채점 정확도 두 기준을 동시에 통과하는가?
- 과제는 10시간 이상 ultra long horizon과 협업(virtual coworker) 을 포함하는가?
- 데이터는 커스텀(소유) 으로 갈 것인가, off-the-shelf(공유) 로 갈 것인가?
한 줄 요약: 프런티어 지능의 병목은 연산도 아키텍처도 아니라, "모델이 못하는 일을 사람이 rubric으로 채점해준 환경이 경제 전체를 커버할 만큼 만들어졌는가" 로 수렴한다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.