[시스템 안내에 따라 표 셀 판독은 이미지 분석(get_images)과 원문 텍스트로 교차 확인해 재구성했습니다.]
Claude로 "압도적으로 빠르게" 개발하는 법 — Boris Cherny 4단계 플레이북 해부
개요
- 주제: Claude Code creator Boris Cherny가 공개한 "AI 파워유저와 나머지를 가르는 4단계" 프레임워크를, 기술 배경이 없는 사람도 오늘 바로 적용할 수 있도록 풀어서 해부한다.
- 핵심 관점: 생산성 격차는 모델 성능의 차이가 아니라 AI를 쓰는 "구조"의 단계 차이에서 발생한다. 단계는 건너뛸 수 없고, 반드시 위에 쌓아 올리는 방식으로 설계되어 있다.
- 핵심 키워드:
Step 0 채팅창→Step 1 AI Assisted→Step 2 AI Builds in Parallel→Step 3 Supervised Autonomy→Step 4 AI Native/ 검증(Verification) / 에이전트 권한(Auto Mode) / 루틴·스킬 / 토큰 경제성
핵심 메시지 3가지
① "AI를 쓴다"와 "AI가 일하게 한다"는 완전히 다른 급이다
발표의 출발점은 충격적인 통계였다. Gallup 연구 기준 미국 노동자의 50%는 AI를 아예 쓰지 않고, 주간/일간 사용자는 28%에 불과하다(01_clDlAmHsiKw.mp4 Page1). 그런데 Cherny의 기준을 적용하면, 채팅창에 질문을 던지고 결과를 손으로 옮겨 붙이는 대부분의 "열심한 사용자"도 사실상 거의 쓰지 않는 사람과 같은 카테고리에 놓인다.
② 병렬화의 열쇠는 더 많은 탭이 아니라 "비(非)인간 검증"이다
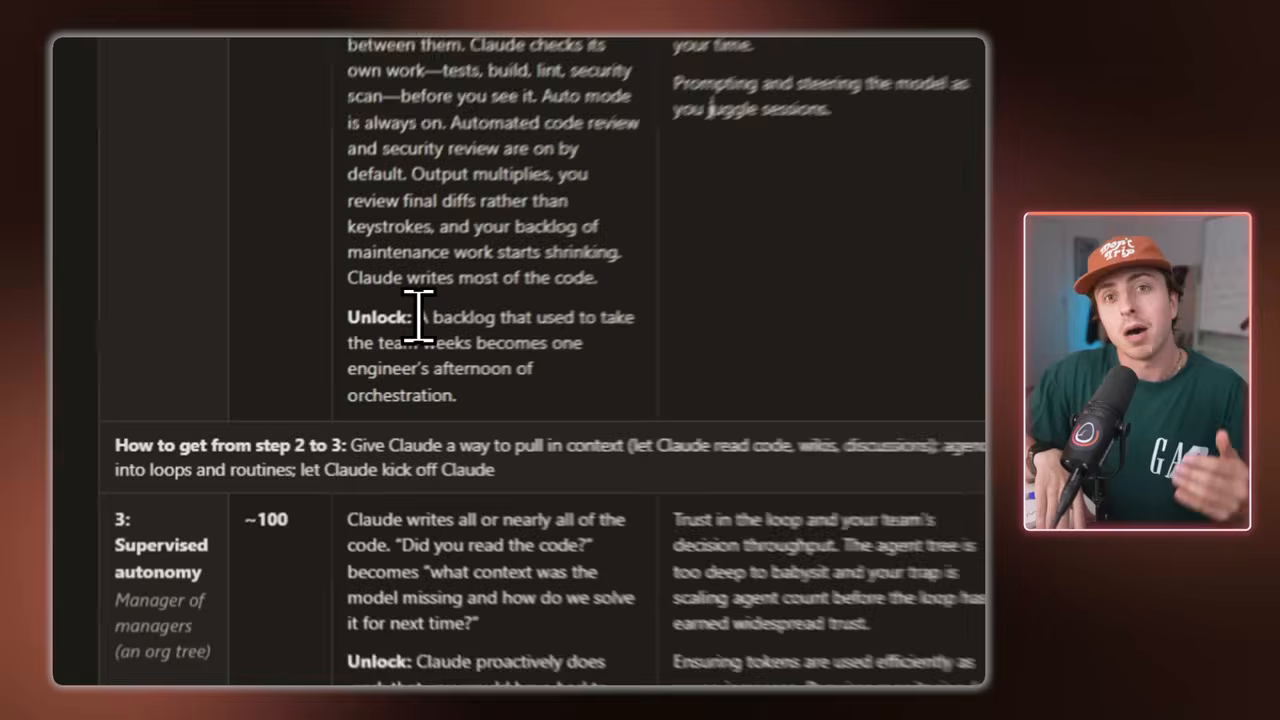
한 사람이 5~10개 에이전트를 오케스트레이션하는 단계로 넘어가는 유일한 관문은, 사람이 모든 결과를 눈으로 확인하는 구조를 깨는 것이다. Cherny의 표현을 빌리면 "팀 몇 주치 백로그가 엔지니어 한 명의 오후로 줄어든다"(01_clDlAmHsiKw.mp4 Page1).
③ 마지막 단계를 막는 것은 기술이 아니라 사고방식과 비용 통제다
"차라리 내가 하는 게 빠르다"는 함정에 갇히면 Step 2에서 멈춘다. 반대로 가드레일 없이 자율성을 열면 하루아침에 단일 작업에서 3,000달러어치 토큰이 증발한 실제 사례처럼 비용이 문제가 된다.
1. Step 0 — 채팅창: "시작점"이지만 머무르면 안 되는 자리
Step 0은 Claude나 ChatGPT를 채팅 창 안에서만 쓰는 상태다. 이는 ChatGPT가 처음 나왔을 때 모두가 시작했던 방식과 동일하다. 채널 시청자의 99%는 이미 이 단계를 지났다고 생각하지만, 발표자는 두 가지 이유를 들어 경계한다.
| 체크 질문 | YES라면 |
|---|---|
| Claude의 출력물을 다른 위치에 복사·붙여넣기 하는가? | 아직 Step 1에 도달하지 못한 것 |
| 외부 데이터를 수동으로 Claude 안에 붙여넣는가? | AI가 맥락을 직접 가져오지 못한다는 신호 |
"AI는 당신을 대신해 정보를 가져오고 문서를 직접 편집할 수 있어야 한다. 그래서 이 복사·붙여넣기 춤을 할 필요가 없어야 한다." (01_clDlAmHsiKw.mp4 Page1)
2. Step 1 — AI Assisted: 첫 번째 패러다임 전환
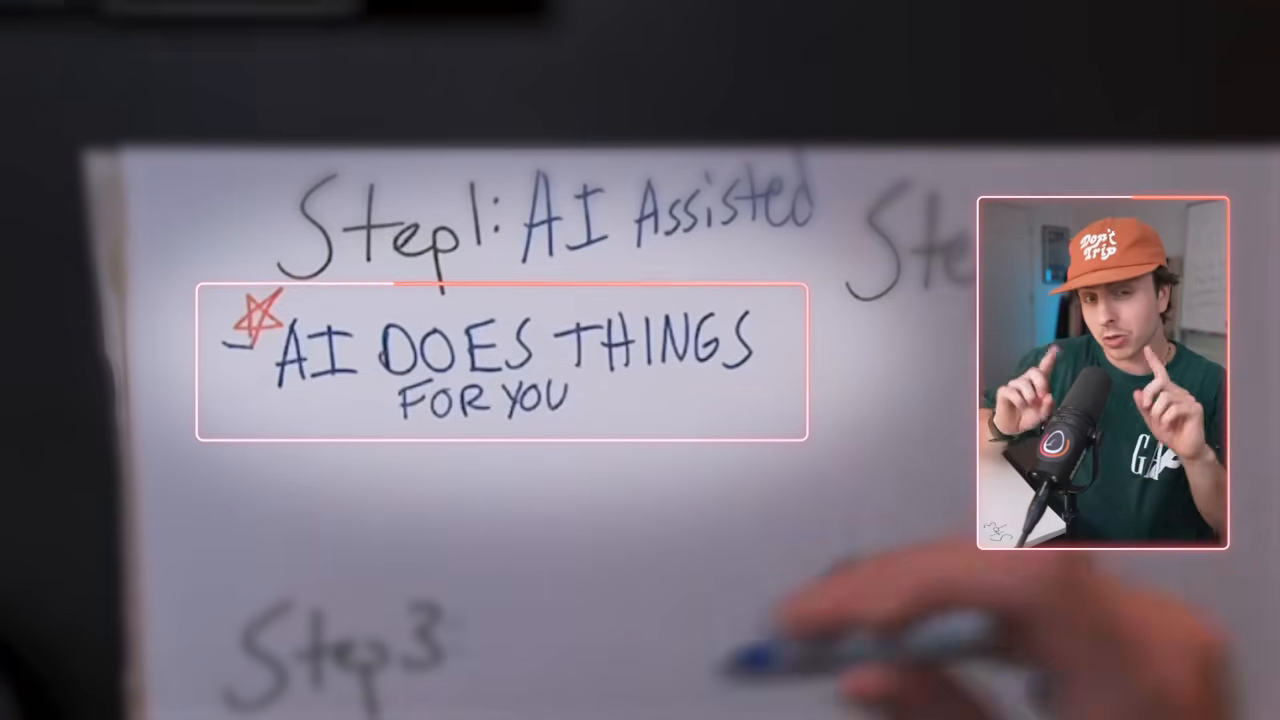
Cherny의 원문 정의는 "엔지니어 1명, 에이전트 1개, 대부분 감독 — 빠른 페어 프로그래머" 다. 세션은 한 번에 하나, 머지 전 거의 모든 변경을 검토한다. 기술처럼 들리지만 실체는 단순하다 — 방 안에 있는 비서다.
- 패러다임 전환의 본질: AI가 질문에 답하는 것 → AI가 당신을 위해 일을 하는 것
- 화이트보드에도 이 한 문장이 빨간 별표와 함께 박스 처리되어 있다: "AI DOES THINGS FOR YOU"(01_clDlAmHsiKw.mp4 Page1)
오늘 하는 세팅 5단계
| 단계 | 동작 | 포인트 |
|---|---|---|
| ① 폴더 생성 | Claude Desktop → Code → 폴더 선택 → Add Another Folder → New Folder | 이름은 "Personal AI System"처럼 나만의 AI 시스템으로 |
| ② 초기화 | 세션에서 /init 실행 |
프로젝트를 AI 협업용으로 최적화 |
| ③ 파일 뷰어 | Obsidian(무료) 설치 후 방금 만든 폴더 열기 | AI가 쓴 파일을 사람이 바로 확인 |
| ④ 외부 연결 | + 버튼 → 연결할 시스템 추가 (예: Notion) | 복사·붙여넣기 없이 에이전트가 데이터를 직접 읽음 |
| ⑤ 검증 | 결과물 확인 규칙 세팅 | Step 2로 넘어가는 관문 |
비개발자도 두려워할 필요 없다 — Claude Code는 코딩 전용이 아니라 내 컴퓨터의 파일을 매끄럽게 편집하는 도구다.
Step 1의 병목 (Cherny 원문 그대로)
"당신의 주의력, 그리고 모델 출력에 대한 신뢰 부족과 자기검증 부재로 인해 모든 응답과 코드 편집을 검사해야 할 필요. 당신은 모든 것을 읽어야 한다고 느껴서 결코 시선을 돌리지 못한다." (01_clDlAmHsiKw.mp4 Page1)
즉 일은 단일 차로 도로(one-lane road) 다. 여기서 다중 차로 고속도로 바꾸는 것이 Step 2다.
3. Step 2 — AI Builds in Parallel: "오케스트레이터"로 역할 전환
Cherny의 정의: 엔지니어 1명이 5~10개 에이전트를 동시에 조율하고, 각 에이전트는 독립된 작업 트리에서 일하며 사람은 그 위를 뛰어다닌다. 핵심은 역할 이름이 Orchestrator(지휘자) 라는 점 — 탭을 여러 개 열어두는 것과 다르다.
① 에이전트가 끝까지(end-to-end) 일한다
↓
② 에이전트가 스스로 출력물을 점검한다
↓
③ 사람은 중간 단계가 아니라 최종 결과물만 본다
↓
④ 몇 주치 백로그 → 한 오후의 오케스트레이션
고레버리지 변화 ① — 두 가지 검증
| 구분 | Rule-based 검증 | Taste-based 검증 |
|---|---|---|
| 정의 | 규칙으로 객관적 판정 | 주관적 품질을 AI가 판정 |
| 판정 형태 | Pass or Fail (예/아니오) | 품질 기준 통과 여부 |
| 개발 예시 | 린트, 자동 테스트, 타입 체크 | — |
| 비개발 예시 | 올바른 색상? 올바른 폰트? em-dash 사용? | 디자인이 괜찮아 보이는가? 글이 간결한가? 보내도 부끄럽지 않은가? |
| 확장성 | 기계공학 등 정량 규정 분야에서는 목록이 크게 늘어남 | 개인 취향 학습이 필요해 초기 세팅이 까다롭지만 효과 큼 |
두 스킬을 한 번에 만드는 프롬프트 구조 (01_clDlAmHsiKw.mp4 Page1 화면 판독):
- "First, interview me one question at a time until you understand what I produce and what a correct version looks like."
- "Then build both: ① A rule-based check — objective pass/fail rules only (formatting, naming, required sections, fonts, colors, no em-dashes, anything with a right answer) ② A taste-based check — the subjective stuff (concise? over-complicated? would I be embarrassed to send this)"
- "Run both against your own output before you show me anything."
고레버리지 변화 ② — 에이전트 권한 (Auto Mode)
- mental model: 에이전트는 "취습생(drunk intern)" 처럼 다룬다. 망가뜨릴 수 있는 접근 권한이 있으면 반드시 망가뜨린다 → 그 가능성을 제거하라.
- 실행: Claude에서 + 옆을 클릭 → auto 선택. 위험도가 낮은 항목은 자동 승인, 위험한 항목만 승인 요청.
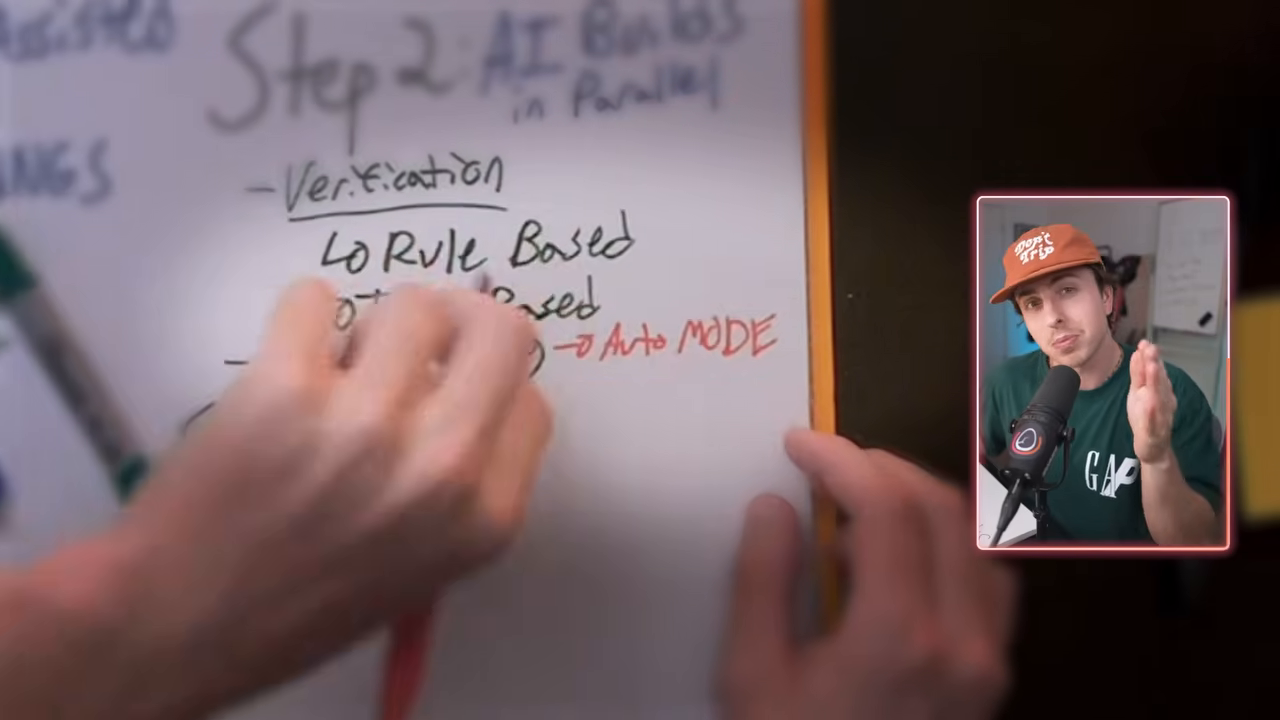
- 화면의 화이트보드에도
Step 2: AI Builds in Parallel→- Verification→Rule Based / Taste Based→→ Auto MODE가 빨간 글씨로 이어져 있다(01_clDlAmHsiKw.mp4 Page1).
병렬 작업을 어떻게 쪼개는가
| 유형 | 정의 | 분리 방법 |
|---|---|---|
| Cross-project | 서로 전혀 무관한 작업 (본업 vs 사이드 프로젝트) | /projects 폴더 아래 /Build Partner, /Internal OS, /Incubator Website, /Clients 처럼 도메인별 폴더 분리 → Claude Code에서 프로젝트 선택 |
| Inter-project | 같은 프로젝트 내 독립 단위 | 개발자=앱의 다른 부분, 영업=다른 고객 제안서, 크리에이터=다른 대본. 겹치지 않는 작업 단위로 분리 |
4. Step 3 — Supervised Autonomy: 두 번째 패러다임 전환
이제 당신은 AI 에이전트의 CEO다. 조직도 최상위에 서고 아래를 이끈다.
- 해금 조건: "Claude가 당신이 예전엔 수동으로 시작해야 했던 일을 선제적으로 수행한다. 유지보수·정리는 누군가 시간을 낼 때까지 기다리지 않고 백그라운드에서 계속 실행된다."(01_clDlAmHsiKw.mp4 Page1)
- 코드 작성 주체가 사람 → Claude로 완전히 넘어간다. "코드 읽었어?"라는 질문이 "모델에게 어떤 맥락이 빠졌고 다음엔 어떻게 해결할까?"로 바뀐다.
- 이 단계의 수치 지표는 약 100 규모로 제시된다(01_clDlAmHsiKw.mp4 Page1 슬라이드).
Step 2에 발 묶는 가장 흔한 믿음
"차라리 내가 AI 쓰면서 직접 하는 게 빠르다."
대부분의 경우 이 말은 사실이다. 그러나 그게 요점이 아니다. 발표자가 2021년 Evan Venator에게서 듣고 그 주에 계약자 2명(소셜미디어 매니저 Liam, 영상 편집자 Sarah)을 고용했던 경험이 이걸 뒤집는다.
| 구간 | 결과 |
|---|---|
| 첫 2주 | 교육·트레이닝 때문에 오히려 더 오래 걸림 |
| 그 이후 | 빨라짐 |
| 나중엔 | 본인이 전혀 개입하지 않음 → 자신을 중간에 두지 않고 출력을 확장하는 팀 완성 |
"Lose the battle to win the war." 오늘 시간이 더 걸려도 장기적으로 시간을 절약한다면 하라.
CEO가 할 3가지
| # | 과제 | 실행 수단 |
|---|---|---|
| 1 | 표준 운영 절차(SOP) 만들기 | 재사용 가능한 Claude Skills. 추천 방식은 output-driven skill creation — 이미 잘 만든 결과물(예: PDF 내보내는 주제 리서치)을 Claude와 왕복하며 완성한 뒤, 그 대화 프로세스를 스킬로 고정 |
| 2 | 전달 일정·소통 기대치 세팅 | Routines로 스케줄링("매주 월요일 8시 이 리포트를 나한테 보내") + 결과 보고 채널. 예: Slack의 company updates(1인이면 automation updates)에 send Slack update 스킬을 루틴에 첨부. WhatsApp/Telegram도 무방 — 자기가 실제로 확인하는 위치에 |
| 3 | 병목 찾아 풀기 | Subagents — 리서치라면 YouTube·Google·Twitter·Instagram·이메일 각 채널에 하위 에이전트를 배치해 fan-out으로 동시 수행 |
5. Step 4 — AI Native: 루프가 닫히는 순간
Cherny의 정의: "루프가 완전히 닫히고, 대부분의 에이전트는 Claude가 시작한다. 수백~수천 개 에이전트가 실행되고, 당신은 의도로 조향하고 예외로 모니터링한다."(01_clDlAmHsiKw.mp4 Page1)
- 시작하지 않는다. 확인하지 않는다. 잘못된 것만 본다.
- 영향: "분기 단위 마이그레이션이, 시작하고 가끔 들여다보는 하나의 워크플로우가 된다."
- 그리고 이 단계가 AI를 두려우면서도 동시에 매력적으로 만드는 지점이다 — 재귀적 피드백 루프가 사람 개입 없이 만들고 고치므로, AI는 선형이 아니라 지수적으로 좋아진다.
도달하려면 잘해야 하는 두 가지
① 자동화 후보를 고르는 안목 — 80% 규칙에 단서 하나를 붙인다.
| 판정 기준 | 처리 |
|---|---|
| 80% 품질로 충분하다 | 자동화하라 (good is good enough) |
| 품질이 결정적으로 중요하다 | 엔드투엔드 자동화하지 마라 |
② 토큰 소비를 경제적으로 유지 — 아래 두 가드레일이 전부다.
| 가드레일 | 내용 |
|---|---|
| MVM (Minimum Viable Model) | 태스크별 최소 필요 모델 지정. 단순 작업에 최고급 모델을 쓰는 건 그냥 토큰 낭비 |
| 최대 반복(iteration) 상한 | 루틴·루프의 반복 횟수 상한 설정. 실제 사례: 가드레일 없는 Step 3 클라이언트가 아침에 일어났더니 단일 작업에서 3,000달러 이상 태움 — 루프에 갇혀 돈을 불태운 것 |
6. 4단계 한눈에 정리
| 단계 | 이름 | 당신의 역할 | 핵심 동작 | 병목 |
|---|---|---|---|---|
| Step 0 | 채팅창 사용자 | 질문자 | AI가 답만 함 | 복사·붙여넣기 |
| Step 1 | AI Assisted | AI를 쓰는 실무자 | 1엔지니어 : 1에이전트, 매 변경 검토 | 주의력 — 모든 것을 읽어야 함 |
| Step 2 | AI Builds in Parallel | AI 매니저(Orchestrator) | 1 : 5~10 에이전트 병렬, 최종 diff만 검토 | 프롬프트·조향에 묶인 시간 |
| Step 3 | Supervised Autonomy | AI 매니저들의 매니저(CEO) | Claude가 선제적으로 백그라운드 실행, 규모 ~100 | 루프에 대한 신뢰와 팀의 의사결정 처리량, 토큰 효율 |
| Step 4 | AI Native | 의도만 제시하는 지휘자 | 수백~수천 에이전트, 예외만 모니터링 | (자동화 후보 선별·비용 통제) |
패러다임 전환은 두 번: Step 1(AI가 답 → AI가 일을 함), Step 3(AI가 수동 시작 → AI가 선제 실행).
관점 포인트
- 단계는 순서가 아니라 의존성이다. Step 1의 검증·연결이 없으면 Step 2는 "검증 병목"으로 오히려 느려진다.
- "탭 여러 개 = 병렬"은 오해다. 병렬이 성립하려면 에이전트가 스스로 검증하고 최종물만 올려야 한다.
- 권한 설계는 성능 설정보다 먼저다. Auto Mode는 "골디락스 존" — 기본값을 굳이 건드릴 필요가 없다.
- 검증 스킬은 한 번 만들고 끝이 아니라 취향 학습으로 다듬는다.
- 오늘 느려지는 투자가 내일 복리가 된다. 스킬·루틴·보고 채널은 팀을 늘리듯 쌓는 SOP다.
- 자율성을 열기 전에 비용 상한을 걸어라. 반복 상한과 MVM은 선택이 아니라 안전장치다.
- 자동화 경계선은 하나다. "좋음이 충분한가?" — 예면 위임, 아니오면 사람이 최종 품질을 소유.
최종 핵심 정리
- 내 워크플로우에 복사·붙여넣기가 남아 있는가? → 아직 Step 1 이전이다.
- AI의 모든 출력을 내가 눈으로 읽고 있는가? → Step 2로 갈 검증 장치가 없다.
- Rule-based와 Taste-based 두 개의 검증 스킬이 실제로 존재하는가?
- 에이전트에게 위험 자동승인/요청(Auto Mode) 경계를 설정했는가?
- 반복 작업이 스킬 + 루틴 + 보고 채널 3종 세트로 도는가?
- 루프에 최대 반복 횟수와 태스크별 최소 모델(MVM) 이 걸려 있는가?
- "내가 하는 게 빠르다"는 판단이 오늘 기준인가, 복리 기준인가?
한 줄 요약: AI 생산성 격차는 좋은 프롬프트에서 나오지 않고, AI가 스스로 검증하고 끝까지 일하게 만드는 4단계 구조에서 나온다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.