THE-X: 눈을 가린 채 문장을 읽는다 — 동형암호로 Transformer 추론을 지키는 방법
개요
- 주제: ACL 2022 Findings 게재 논문 "THE-X: Privacy-Preserving Transformer Inference with Homomorphic Encryption" 해설
- 핵심 관점: 동형암호(HE)는 이론적 프라이버시 보장을 주지만, Transformer의 비다항 함수(GELU·softmax·LayerNorm)를 처리하지 못한다 — THE-X는 이를 근사로 대체하고, 근사가 남긴 오차를 실험으로 계량한다
- 핵심 키워드: THE-X, 동형암호(HE), BERT-tiny, GELU→ReLU 대체, softmax 추정망, LN-Distill, Glue 평균 성능 저하 1.48%
핵심 메시지 3가지
1. "이론적 보장"과 "실행 가능성" 사이의 간극이 논문의 출발점이다
저자는 클라우드 배치 사전학습 모델의 프라이버시 위협을 두 가지 도전으로 나눈다. 첫째는 제3자 서비스 제공자가 사용자 평문 데이터에 접근하지 못하게 하는 문제이며, 차별적 프라이버시(DP) 계열 선행 연구는 "eavesdropping attackers"에 취약하고 "privacy protection could never be theory-guaranteed"라고 저자는 평가한다 [원문 §1]. 둘째는 성능 문제로, TextHide·FedNLP 같은 연합학습 기반 선행 연구는 "at cost of considerable performance dropping"을 지불하며 학습 데이터 프라이버시에 집중했을 뿐 추론 단계 프라이버시는 "have not fully explored"했다고 저자는 주장한다 [원문 §1].
2. THE-X의 두 축은 "사용자 디바이스 편입"과 "비다항 함수 근사"다
저자에 따르면 THE-X에는 두 개의 핵심 아이디어가 있다 — "The first one is to incorporate the user device into the HE inference, and the second is using 'simplified computation' to approximate the non-polynomial functions" [원문 §3]. 전자는 ReLU의 Max 연산을, 후자는 GELU·softmax·LayerNorm을 담당한다.
3. 성능 저하는 실재하지만 국소적이다 — 평균 1.48%, 단 태스크별 편차가 크다
GLUE 평균 성능 저하는 1.48%(HE 설정 기준)이며, 저자는 그중 1.08%가 LayerNorm 근사에서, softmax 추정망 기여도는 평균 0.09%에 그친다고 보고한다 [원문 §4.3]. 다만 회귀 태스크인 STS-B에서는 피어슨 4.44%, 스피어먼 2.69%로 저하가 집중된다.
왜 이 문제가 되는가 — 선행 연구가 남긴 두 개의 구멍
동형암호는 "perform computations on encrypted data without first decrypting it"라는 개념으로, 암호문에 대한 연산 결과를 복호화하면 평문 연산 결과와 동일하다는 성질을 갖는다 [원문 §2.2]. 저자는 HE의 의미식 보안이 격자 기반 암호학에 의해 보장된다고 서술하며, 이를 "theory-guaranteed" 프라이버시의 근거로 제시한다.
그러나 선행 경로에는 각각 한계가 있었다.
| 선행 경로 | 대표 연구 | 저자가 지적한 한계 |
|---|---|---|
| 차별적 프라이버시(DP) | Dwork et al., 2006; Abadi et al., 2016 | 도청 공격자에 취약, 이론적 보장 불가 [원문 §1] |
| 연합학습 기반 | TextHide (Huang et al., 2020) | 문장 수준 태스크에만 적용 가능, mix-up 연산 때문에 NER·SRL 같은 토큰 수준 태스크 실패 [원문 §2.1] |
| 연합학습 기반 | FedNLP (Lin et al., 2021) | 상당한 성능 저하 동반, 학습 데이터 프라이버시에 집중 [원문 §1] |
| DP 파인튜닝 | DP-finetuning (Kerrigan et al., 2020) | GPT-2 생성 모델에서 20% perplexity 성능 희생 [원문 §2.1] |
| HE 백엔드 | Intel HE transformer (Boemer et al., 2019a,b, 2020) | 연구 도구 수준, Transformer의 복잡한 연산 미지원 [원문 §2.2] |
[[그림:img_p1_4.jp2|THE-X가 상징하는 "눈을 가린 채 처리한다"는 은유 — 논문은 "process users' data with its eyes blind"라고 표현한다 (R12_THE_X.pdf Page1)]]
한편 저자는 선행 연구의 기여도를 균형 있게 인정한다. gradient leakage로 원시 데이터 복구가 가능함을 보인 연구(Zhu and Han, 2020; Zhao et al., 2020)가 "이론적 보장 부재"라는 문제의식을 제공했고, HE transformer 백엔드(Boemer et al., 2019b,a, 2020)는 THE-X의 직접적 기반이다. 저자가 "first work to explore the privacy-preserving transformer inference with HE"라는 기여 주장은 HE 기반 Transformer '추론'에 한정된 것이다.
어떻게 작동하는가 — 근사 방법론의 성립 조건
성립 조건: 왜 "덧셈과 곱셈만"이 문제인가
논문이 제시하는 기술적 전제는 명확하다. PHE는 덧셈 또는 곱셈 중 하나만, FHE는 둘 다, LHE는 고정된 계산 깊이까지 지원하며 — "composing addition and multiplication suffices to construct polynomial functions"이므로 다항함수는 근사 가능하다. 반면 "this limitation prevents the exact computation of any comparison-based operations such as Max, Min, as well as common functions such as exponential or sigmoid" [원문 §2.3]. GELU의 Gaussian kernel(지수), softmax의 exp·나눗셈, LayerNorm의 나눗셈이 모두 여기 해당한다.
3단계 근사 파이프라인
① GELU → ReLU (Standard Finetuning 단계)
↓
② softmax → 3층 선형 신경망 T 추정 (S frozen 조건에서 파인튜닝)
↓
③ LayerNorm → 선형 대체 + LN-Distill (기존 파라미터 freeze 조건에서 증류)
↓
④ 원본 LN 제거 → HE transformer로 변환
- GELU: 구현상 정의된 근사식 \(G(x) = 0.5x(1+tanh[\sqrt{2/\pi}(x+0.044715x^3)])\)의 tanh도 여전히 비다항이라 HE 미지원이므로, ReLU로 교체한다. 저자는 GELU와 ReLU의 수치 비교에서 "With an input around zero, the activation results are very close. With a larger or smaller input value, the activation results tend to converge"라고 관찰을 서술한다 [원문 Figure 3]. ReLU의 Max는 클라이언트 통신으로 구현 — 서버가 암호문을 클라이언트에 보내면 클라이언트가 복호화 후 로컬 Max를 수행해 재암호화해 반환하며, "no plaintext is leaked during the TLS connection"이 성립 조건이다 [원문 §3.1.1].
- softmax: 대안으로 검토된 Taylor 급수 근사(Vincent et al., 2015)는 지수 연산만 근사 가능하고, softmax-free linear attention(Lu et al., 2021)의 newton-inverse 근사는 "approximation error is unbounded in full-scale attention settings"라는 한계 때문에 저자는 채택하지 않았다 [원문 §3.1.2]. 대신 \(S(x_i) = x_i * T(\Sigma_j ReLU(((x_j)/2 + 1)^3))\) 형태의 추정망을 설계하고, [-3, 3] 범위의 랜덤 텐서를 입력으로 100k 스텝, 학습률 1e-3에서 학습해 MSE loss 1e-6에 수렴시킨다 [원문 §3.1.2].
- LayerNorm: 나눗셈이 포함된 원식 대신 \(\hat{y} = x \circ \tilde{\gamma} + \beta\)의 선형 대체를 쓰되, "To avoid the introduction of new parameters, we keep the learnable parameters"라는 조건에서 \(\tilde{\gamma}\)가 표준편차를 회귀로 예측하게 한다. 저자는 "We find the simple linear replacement is enough for values with a small scale of bias"라고 한정한다 — 즉 작은 편차 범위에서만 성립하는 주장이다 [원문 §3.1.3].
저자가 실제 사용한 주요 설정과 예외
| 항목 | 저자의 실제 설정 | 예외·단서 |
|---|---|---|
| 백엔드 | HE-transformer + CKKS 스킴, Microsoft SEAL 구현 | TensorFlow checkpoint만 지원 → PyTorch 계열은 변환 필수 [원문 §2.2, §3.1.4] |
| 어텐션 스케일링 | \(1/\sqrt{d_k}\)를 query projection 가중치에 흡수 | — [원문 §3.1.4] |
| linear projection | 지원되는 dense 연산 부재로 fully kernel convolution 대체 | — [원문 §3.1.4] |
| pooler | tanh 미지원으로 drop | pooler 제거는 Figure 2 워크플로에도 포함 [원문 §3.1.4] |
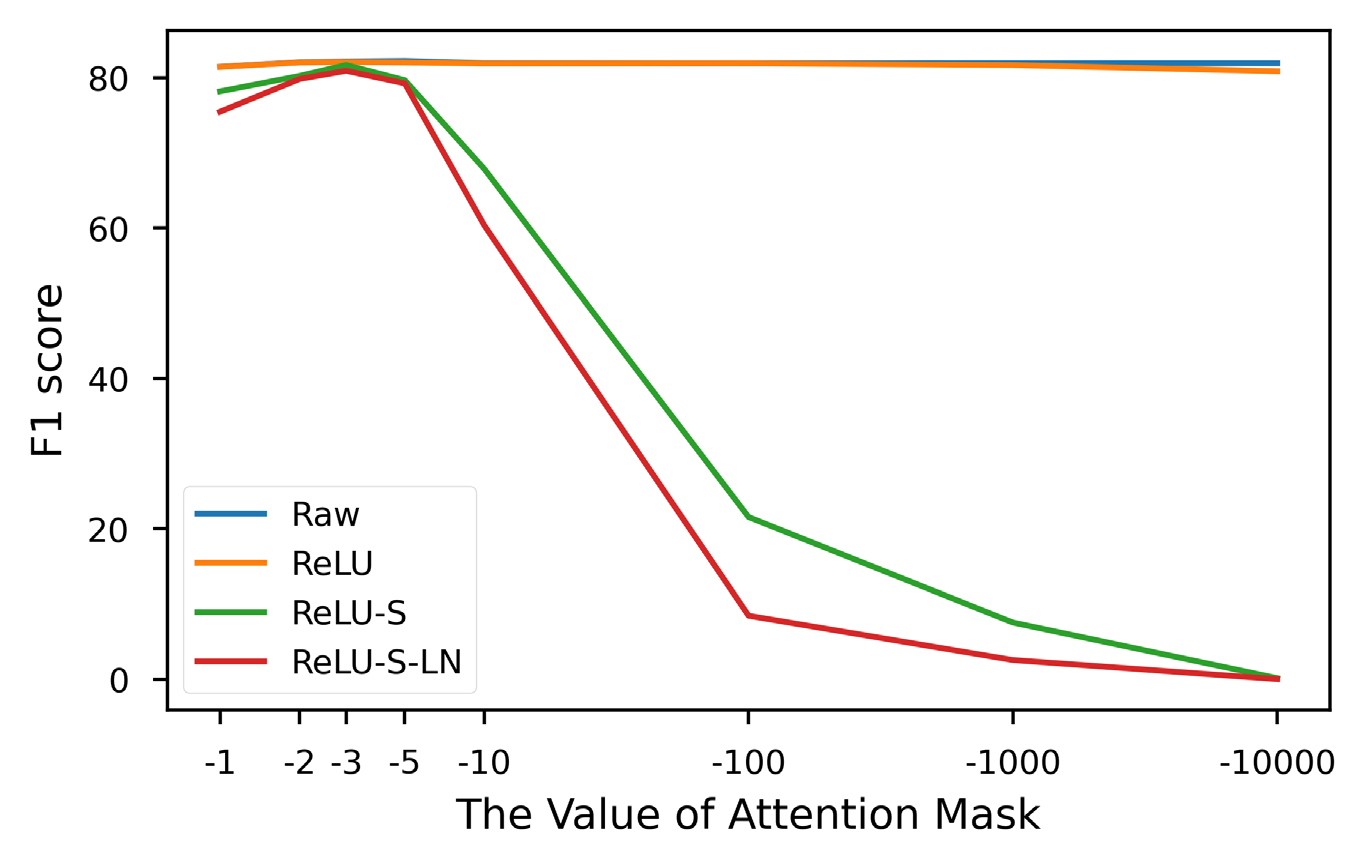
| 마스크 값 | Negative Infinity 대신 -2 ~ -5 사이의 중간값 권장 | 본문은 "between -2 and -5", Figure 4 캡션은 "[-3, -5]"로 표기가 다르다 [원문 §4.4] |
| Attention Overflow | 정규화 전 어텐션 점수 극단값 1e4 관측 → Adam weight decay로 정규화 | weight decay 증가는 NLI 태스크에서 성능 상한을 해칠 수 있는 trade-off [원문 §4.5] |
| 워크플로 스케줄 | Two Stages(softmax estimation model 동결 → 표준 파인튜닝 → best checkpoint 선택 → LN-Distill)가 기본 권장 | Joint 학습 시 STS-B는 "pulling the performance down to 0.4%" — 저자는 이를 bi-level optimization 문제로 해석한다 [원문 §4.6] |
실제 결과 — 숫자로 보는 THE-X
GLUE 벤치마크 (BERT-tiny, development set)
| 태스크 | |D| | 유형 | Baseline | HE | Perf ↓ |
|---|---|---|---|---|---|
| SST-2 | 67k | Sentiment | 82.45 | 82.11 | 0.34 |
| MRPC | 3.7k | Paraphrase | 81.57/70.10 | 79.94/68.87 | 1.63/1.23 |
| STS-B | 7k | Similarity | 72.83/73.66 | 68.39/70.97 | 4.44/2.69 |
| QQP | 364k | Paraphrase | 80.28/84.03 | 78.33/83.63 | 1.95/0.40 |
| MNLI | 393k | NLI | 69.75/70.75 | 68.47/69.08 | 1.28/1.67 |
| QNLI | 108k | NLI | 78.38 | 78.20 | 0.18 |
| RTE | 2.5k | NLI | 58.56 | 58.12 | 0.44 |
| Average | 0.00 | 1.48 | 1.48 |
(출처: R12_THE_X.pdf Page6, Table 1. 서론에서는 평균 저하를 "1.49%"로 표기하며, 본문 §4.3과 Table 1은 1.48%이다 [원문 §1, §4.3])
CoNLL2003 NER (토큰 수준)
| 설정 | Precision | Recall | F1 | Perf ↓ |
|---|---|---|---|---|
| Raw | 82.34 | 84.85 | 83.57 | 0 |
| ReLU | 82.29 | 85.13 | 83.69 | -0.12 |
| ReLU-S | 82.08 | 84.73 | 83.38 | 0.19 |
| ReLU-S-L / HE | 79.65 | 83.79 | 81.67 | 1.90 |
(출처: R12_THE_X.pdf Page6, Table 2)
흥미로운 지점은 ReLU 대체가 F1을 0.12 오히려 향상시킨다는 점이다. 다만 저자는 이를 사실로 확대하지 않고 "We assume the slight improvement may come from unexpected bias"라며 가설로 귀속시킨다 [원문 §4.3]. 마찬가지로 회귀 태스크의 큰 저하에 대해서도 "We assume the regression task needs a higher numerical precision than the classification task"라고 추정을 명시한다.
근사 구성요소별 기여도 분해
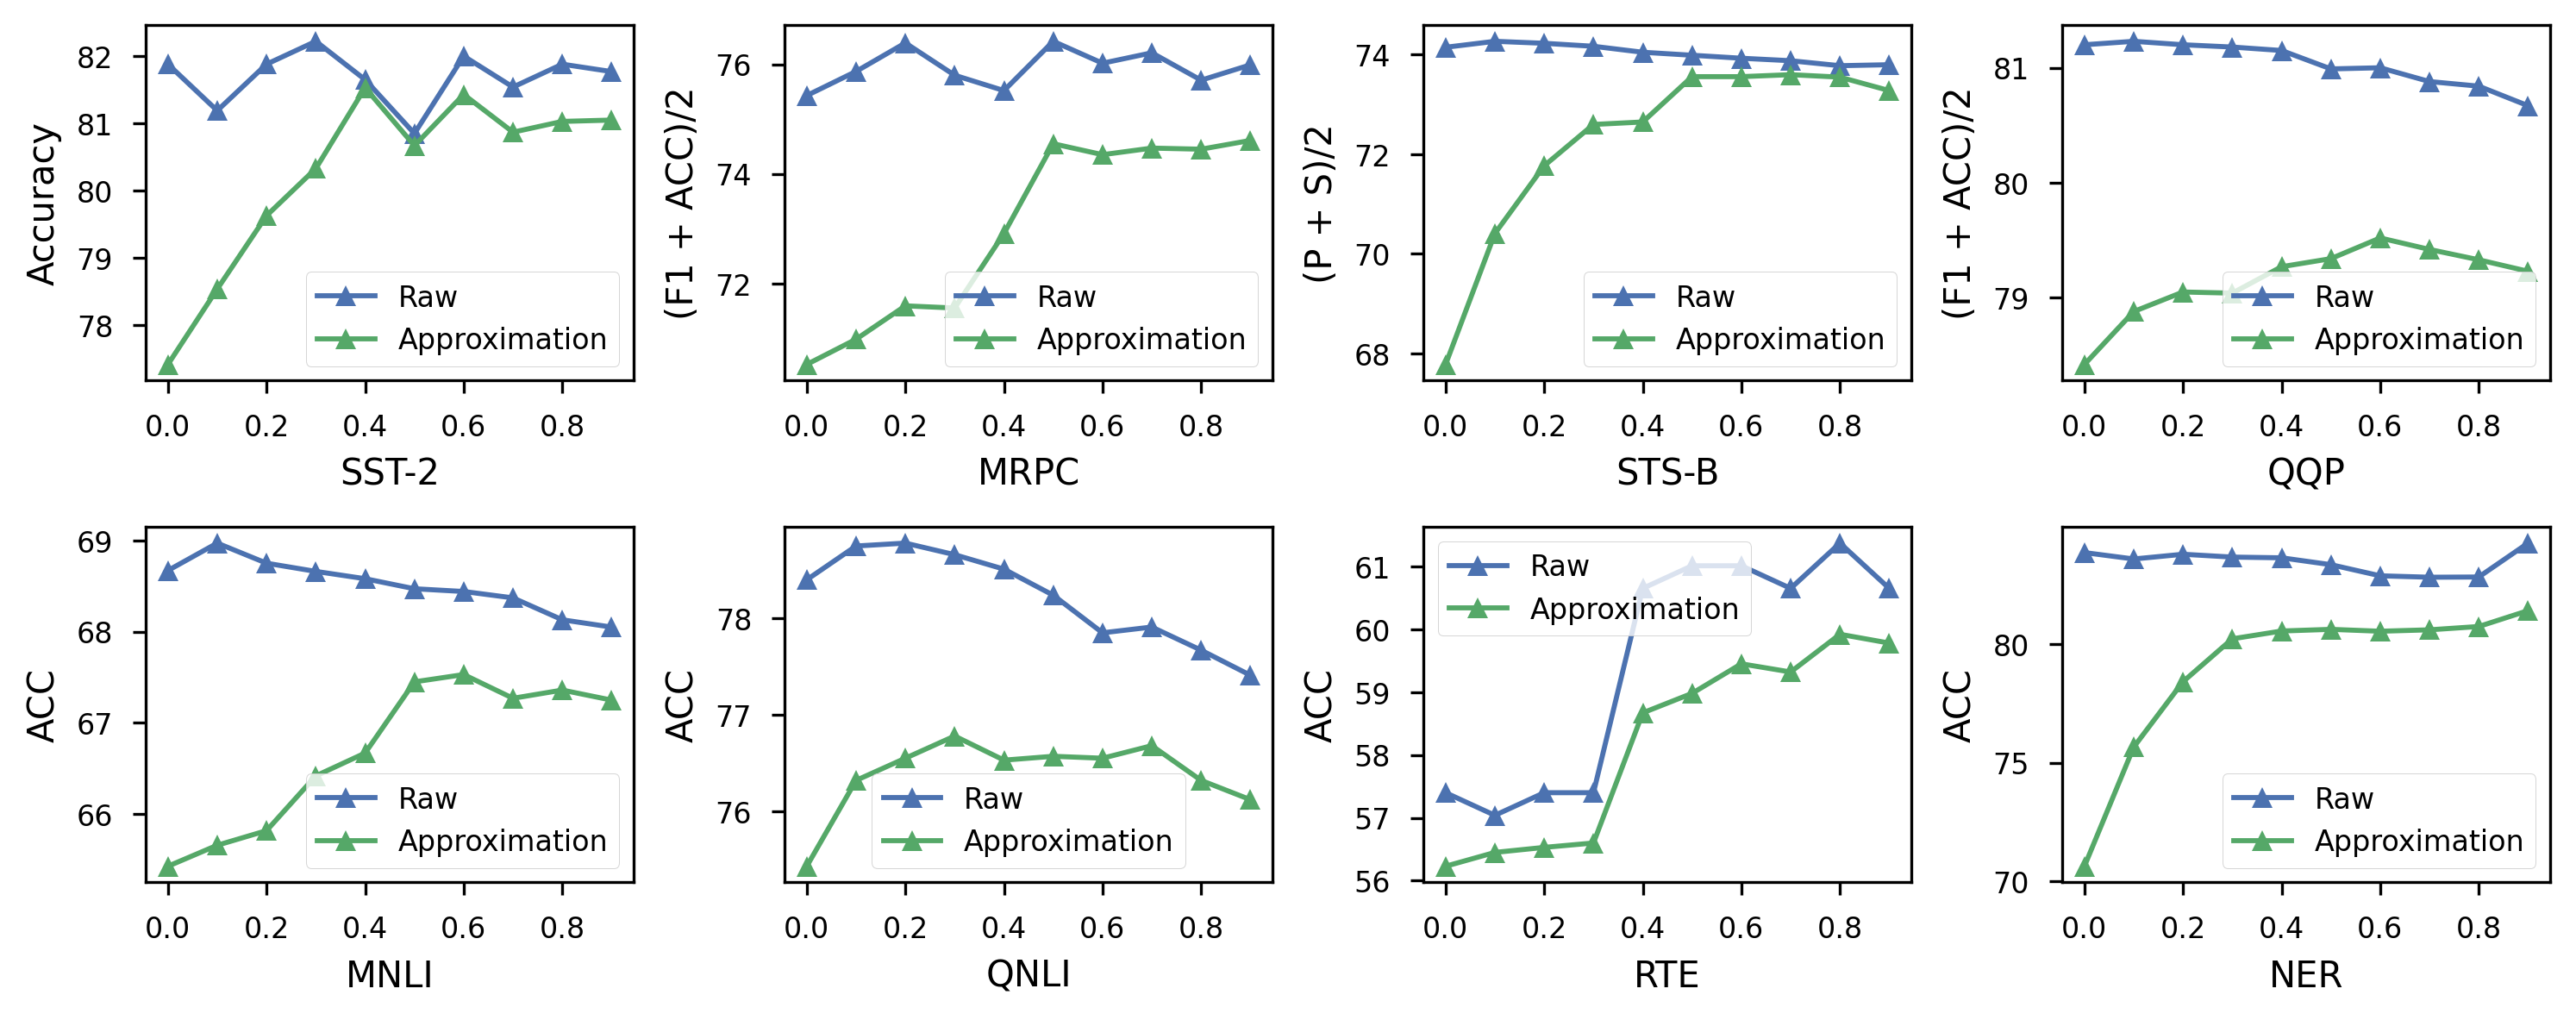
- LayerNorm 근사: 평균 1.08% 저하 — 최대 기여 요인
- softmax 추정망: 평균 0.09% 저하 — 최소 기여 요인, "softmax function could be well imitated by neural networks"라고 저자는 해석
- HE 변환 자체: "quite negligible" — 미세한 저하는 sequence truncation에서 기인한다고 추정 [원문 §4.3]
선행·후속 연구 사이에서 — THE-X의 위치
저자는 결론에서 THE-X를 "a first step in combing homomorphic encryption to address emerging privacy issues in pre-trained models"로 규정하며, "better approximation solutions on different NLP applications"를 위한 후속 연구를 기대한다고 밝힌다 [원문 §5]. 즉 저자 스스로를 탐색적 1차 작업으로 배치한 것이다.
한계도 명시적이다. 데모 모델은 연산 효율성을 위해 BERT-tiny(2 layers, hidden size 128)로 한정되었고, CoLA 태스크는 "BERT-tiny의 용량 제한"으로 보고에서 제외되었다 [원문 §4.1, §4.2]. LayerNorm 근사 오차는 "the approximation error tends to accumulate when the transformer stacks with too many layers" — 층이 쌓일수록 누적된다는 조건이 붙어 있으며, 클라이언트 통신 방식의 Max 구현은 통신 비용을 수반한다 [원문 §3.1.3, §3.1.1].
관점 포인트 — 실무자가 짚어야 할 것
- HE 근사의 본질은 "무엇을 다항함수로 바꿀 수 있는가" — 덧셈·곱셈 조합으로 성립하는 다항 근사만이 HE 위에서 살아남는다
- 비다항 함수의 처리는 두 갈래: 클라이언트로 넘겨 해결(Max)하거나, 신경망으로 대체(softmax 나눗셈)하거나, 회귀로 치환(LayerNorm 표준편차)
- 성능 저하는 평균이 아니라 분포로 봐야 한다 — 평균 1.48%지만 STS-B 4.44% vs QNLI 0.18%의 격차는 태스크 성격(회귀 vs 분류)에서 나온다
- 하이퍼파라미터가 곧 성능이다 — 마스크 값(-2~-5), weight decay, Two Stages 스케줄 세 가지가 근사 성패를 가른다
- 원본 표기의 미세한 불일치에 주의 — 서론의 "1.49%"와 본문·표의 "1.48%"가 공존한다
최종 핵심 정리
확인해야 할 핵심 질문:
- GELU를 ReLU로 바꿔도 되는 조건은? — 0 근처에서 유사하고 양극에서 수렴하는 수치적 관찰 + Max는 클라이언트 통신으로 처리 + TLS 구간에서 평문 노출 없음
- softmax 추정망은 왜 3층 선형인가? — Taylor 근사는 지수만, linear attention은 오차 무계라는 대안의 한계 때문에, 덧셈·곱셈만으로 구성해야 했기 때문
- 왜 Two Stages가 기본값인가? — softmax estimation model과 approximated layernorm을 동시에 학습하면 bi-level optimization 문제에 빠져 STS-B에서 성능이 0.4%까지 떨어지기 때문
- 어떤 태스크에서 위험한가? — 회귀 태스크(STS-B)와 다층 스택 모델, 그리고 토큰 수준 태스크의 LayerNorm 의존 구간
한 줄 요약: THE-X는 "동형암호로 Transformer를 돌릴 수 없다"는 문제를 "무엇을 근사로 바꿀 것인가"의 문제로 재정의했고, 그 대가가 평균 1.48%라는 것을 실험으로 증명한 첫 작업이다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.