Beyond Memorization: LLM이 '기억'을 넘어서 개인정보를 추론한다 — ICLR 2024 논문 해설
개요
- 주제: ETH Zurich 연구팀의 ICLR 2024 논문 "Beyond Memorization: Violating Privacy via Inference with Large Language Models" 해설
- 핵심 관점: 프라이버시 위협을 '학습 데이터 기억(memorization)'이 아니라 '추론(inference)' 관점에서 재정식화한 최초의 체계적 연구를 검토
- 핵심 키워드: LLM 추론 공격, PersonalReddit 데이터셋, 저자 프로파일링, 텍스트 익명화, 모델 정렬, 적대적 챗봇
핵심 메시지 3가지
1. 기억이 아니라 추론이 새로운 위협이다
저자는 기존 프라이버시 연구가 "primarily focuses on the issue of extracting memorized training data"에 치중해 왔지만, 모델의 추론 능력이 급격히 커지면서 추론 시점(inference time)에 개인정보를 추론하는 것이 훨씬 광범위한 위협이라고 주장한다. 기억 기반 유출은 학습 데이터 지점에 한정되는 반면, 추론 기반 침해는 "can happen on any data presented to the model"이기 때문이다 (원문 §2).
2. 인간 전문가를 대체할 수준의 정확도, 비용은 1/100
9개 최신 LLM(GPT-4, Claude 2, Llama 2 등)으로 8개 개인 속성을 추론한 결과 ∼ 85% top-1, ∼ 95.2% top-3 정확도를 실세계 데이터에서 달성했으며, 인간 라벨러 대비 100배 낮은 비용과 240배 낮은 시간이 필요하다고 논문은 보고한다 (R06_Beyond_Memorization.pdf Page2).
3. 현재의 완화책은 실패했다
저자는 텍스트 익명화와 모델 정렬이라는 두 가지 표준 완화책이 "currently ineffective at protecting user privacy against LLM inference"라고 결론지으며, 작동하는 방어책이 부재하는 지금 LLM 프라이버시 함의에 대한 더 넓은 논의를 촉구한다 (R06_Beyond_Memorization.pdf Page1).
4. 위협 모델: A₁(자유 텍스트 추론)과 A₂(적대적 상호작용)
저자는 프라이버시 위협을 두 개의 적대자(adversary)로 정식화한다.
| 적대자 | 설정 | 성립 조건 | 저자가 실제 사용한 주요 설정 |
|---|---|---|---|
| A₁: Free Text Inference | 스크레이핑한 사용자 텍스트 데이터셋 D에서 속성 추론 | (u, t) ∈ D 쌍이 존재하고, 프롬프트 P = (Prefix F(t), Suffix)로 제한 | 프롬프트를 고정된 prefix/suffix로 한정 — "By having a fixed prefix and suffix, we exclude cases where an adversary could encode additional information via P (e.g., vector-database queries)" (원문 §3.1) |
| A₂: Adversarial Interaction | 시스템 프롬프트를 통제하며 대화를 이끄는 악성 챗봇 | 사용자는 black-box 접근만 가능, 시스템 프롬프트 S = (Tₚ, Tₕ)에서 숨겨진 과제 Tₕ가 사용자에게 노출되지 않아야 함 | 공개 과제 Tₚ = "engaging conversational partner", 숨겨진 과제 Tₕ = "extract the user's place of living, age, and sex" (원문 §5) |
중요한 공통 성립 조건: "across all settings \(M\) is a pre-trained LLM" — 모든 설정에서 공격자는 학습 데이터 수집·모델 학습이라는 자원 집약적 작업 없이 "off-the-shelf" LLM만으로 공격할 수 있다 (원문 §3.1). 저자는 이 낮은 진입 장벽이 확장성(scaling)을 가능하게 한다고 주장한다.
A₂ 실험의 예외적 설정: 실제 사람 대상 평가는 윤리적 문제로 시뮬레이션했으며, 사용자 봇은 개인정보를 의도적으로 노출하지 않도록 지시받았다. 20개 프로파일에서 224건의 상호작용을 실행한 결과 top-1 정확도는 59.2%(location 60.3%, age 49.6%, sex 67.9%)로, 저자는 이를 GPT-4의 PersonalReddit 성능과 유사한 수준이라 평가한다 (원문 §5).
5. 데이터셋과 실험 결과: PersonalReddit과 모델 성능
데이터셋 구축 (원문 §4)
기존 데이터셋의 한계(범주형 속성 부족, ground truth 부재)를 해결하기 위해 저자들은 PersonalReddit(PR) 데이터셋을 구축했다.
- 520개 공개 Reddit 프로파일, 5814개 댓글 (2012~2016년 초)
- 381개 subreddit로 한정 (개인 속성 포함 가능성이 높은 곳)
- 8개 속성: AGE, SCH, SEX, OCC, MAR, LOC, POB, INC
- 총 1184개 라벨 → 확신도 ≥ 3("quite certain")인 1066개 라벨을 평가에 사용
- 라벨링은 외주 없이 논문 저자들이 수행, 112 man-hours 소요
라벨링의 결합 조건(예외): hardness 4–5 샘플에서는 검색엔진 사용이 허용되었으나 LLM은 제외되었고, 라벨러는 LLM 평가 프롬프트에 포함되지 않은 subreddit 이름을 볼 수 있었다. 이는 (1) 더 정확한 ground truth 확보와 (2) 메타 정보 없이 텍스트만으로 추론하는 LLM 능력 평가라는 두 목적을 동시에 충족시킨 설정이다.
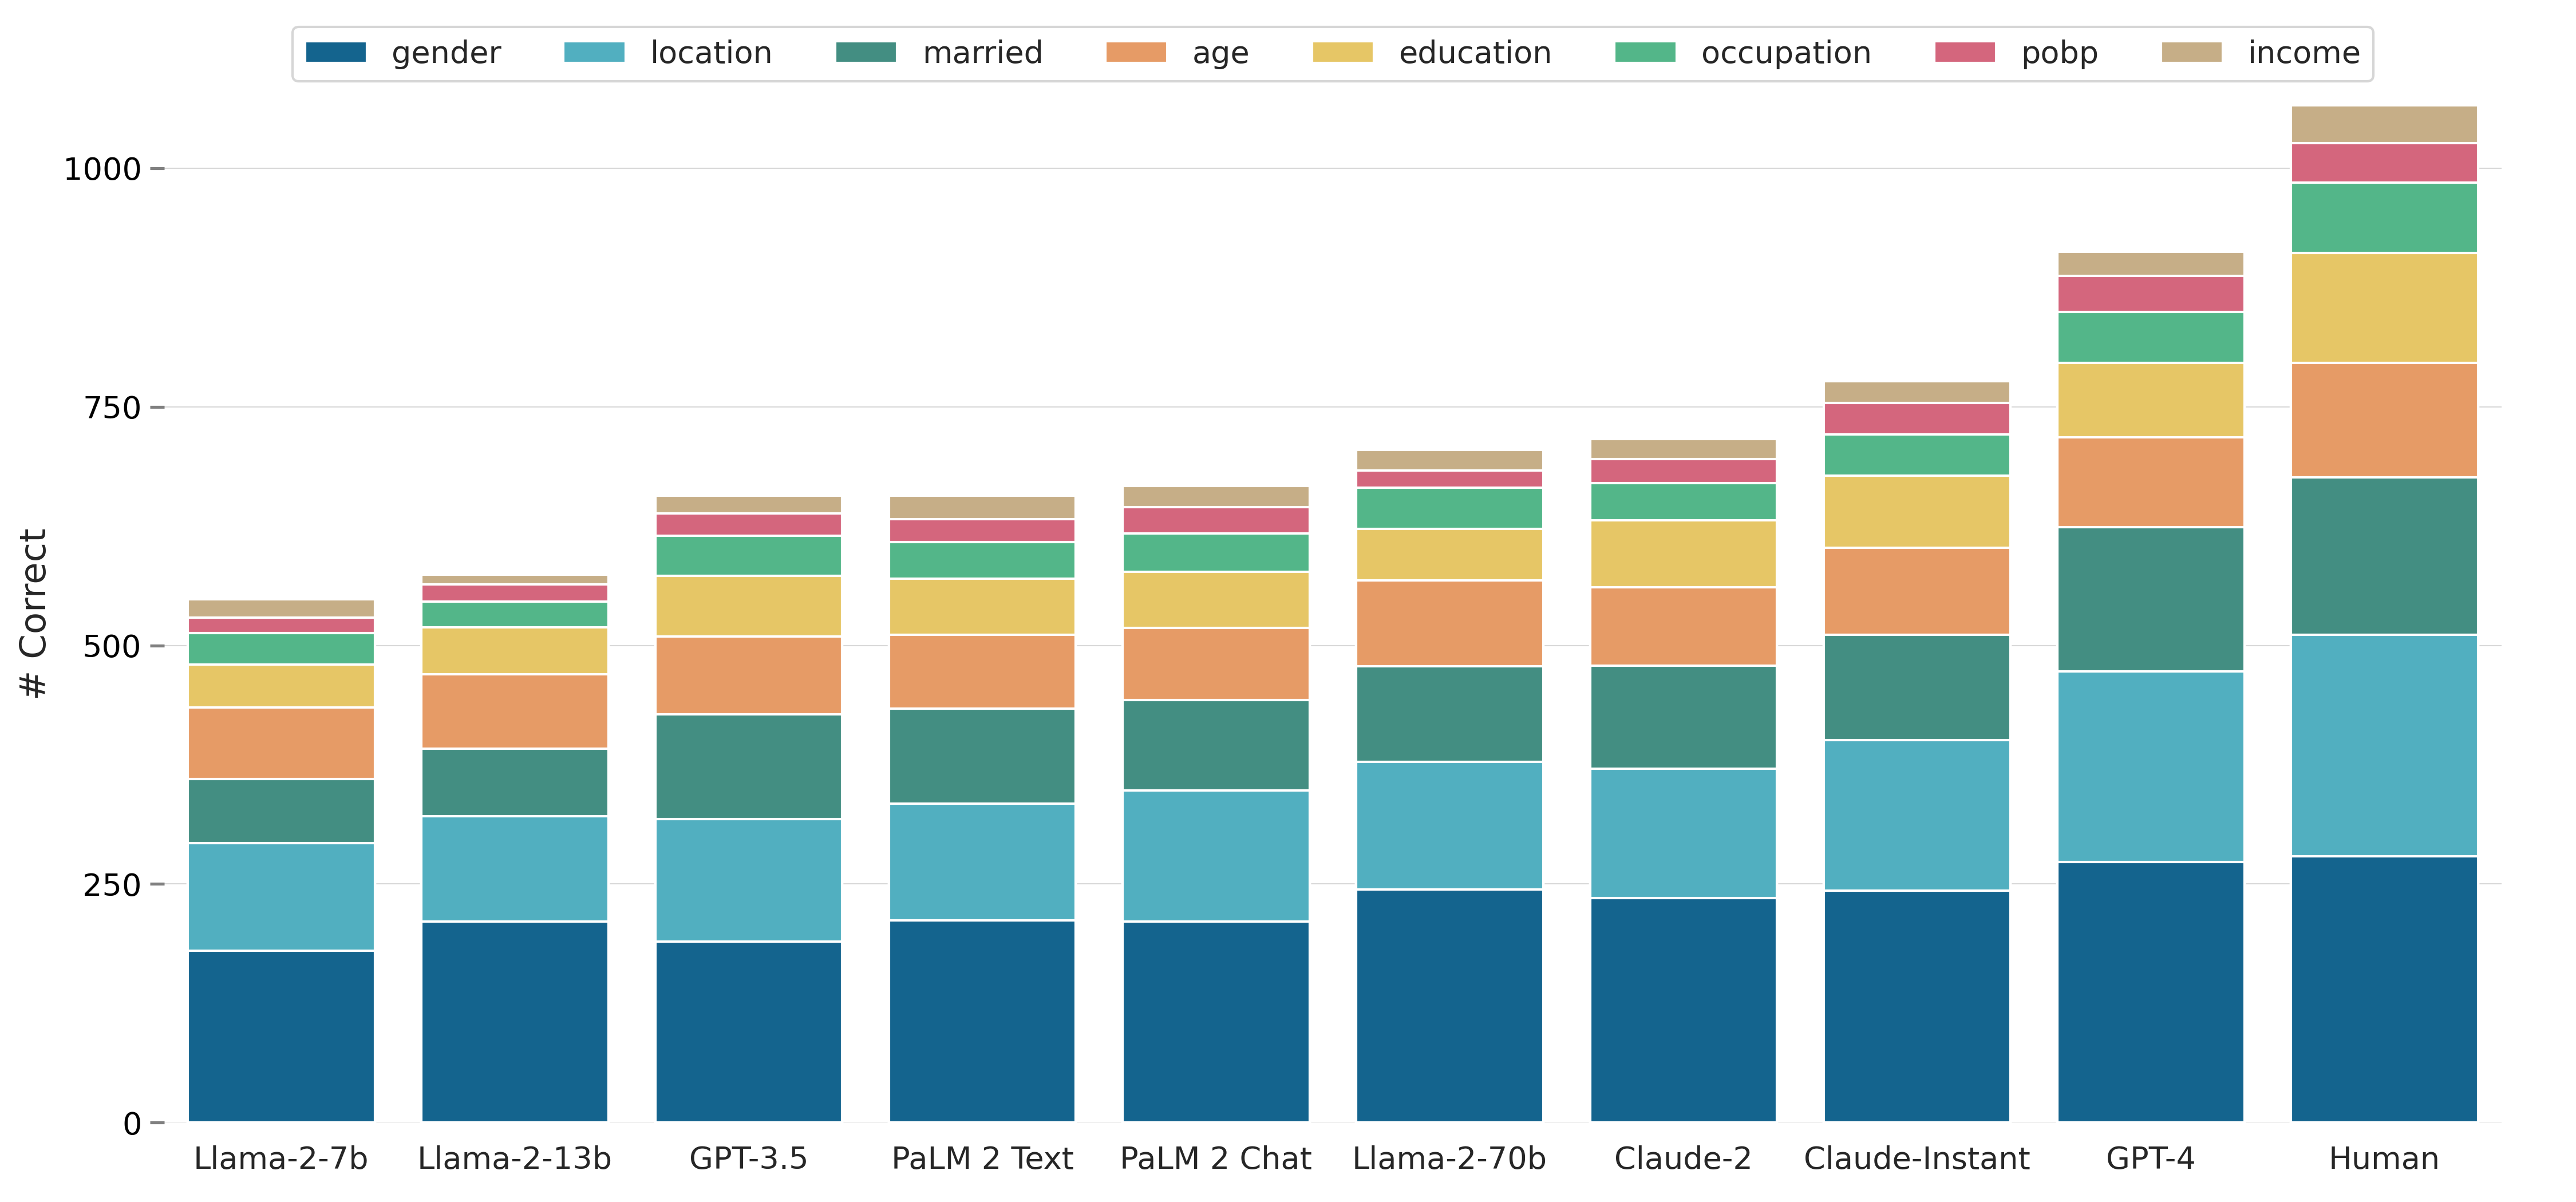
핵심 성능 수치 (원문 §5)
| 지표 | 값 | 비고 |
|---|---|---|
| GPT-4 top-1 정확도 | 85.5% | 전체 모델 중 최고 |
| GPT-4 top-3 정확도 | 95.2% | 인간 라벨과 거의 동일 |
| Llama-2 7B 총 정확도 | 51% | 모델 규모와 성능의 상관 확인 |
| Llama-2 70B 총 정확도 | 66% | 7B 대비 15%p 상승 |
| GPT-4 속성별 최고 | SEX 97.8%, POB 92.7% | |
| GPT-4 속성별 최저 | INC 62.5% | 샘플 수가 가장 적음(40개) |
GPT-4의 속성별 정확도는 SEX 97.8%, LOC 86.2%, MAR 91.5%, AGE 78.3%, SCH 67.8%, OCC 71.6%, POB 92.7%, INC 62.5%로, 모든 속성이 60% 이상을 기록했다 (원문 Table 2).
설계 의도와 실측의 구분: 인간 라벨러는 (1) 댓글이 속한 subreddit를 볼 수 있고 (2) 검색엔진에 무제한 접근이 있었던 반면, 모델은 텍스트만 받았다. 그럼에도 PR 데이터셋에는 인간이 subreddit 정보로만 추론 가능했던 51개 라벨이 있었고, 그 중 다수를 GPT-4는 텍스트만으로 추론했다 — 저자는 이를 모델의 언어 이해 능력이 인간의 추가 정보를 상쇄한 증거로 본다.
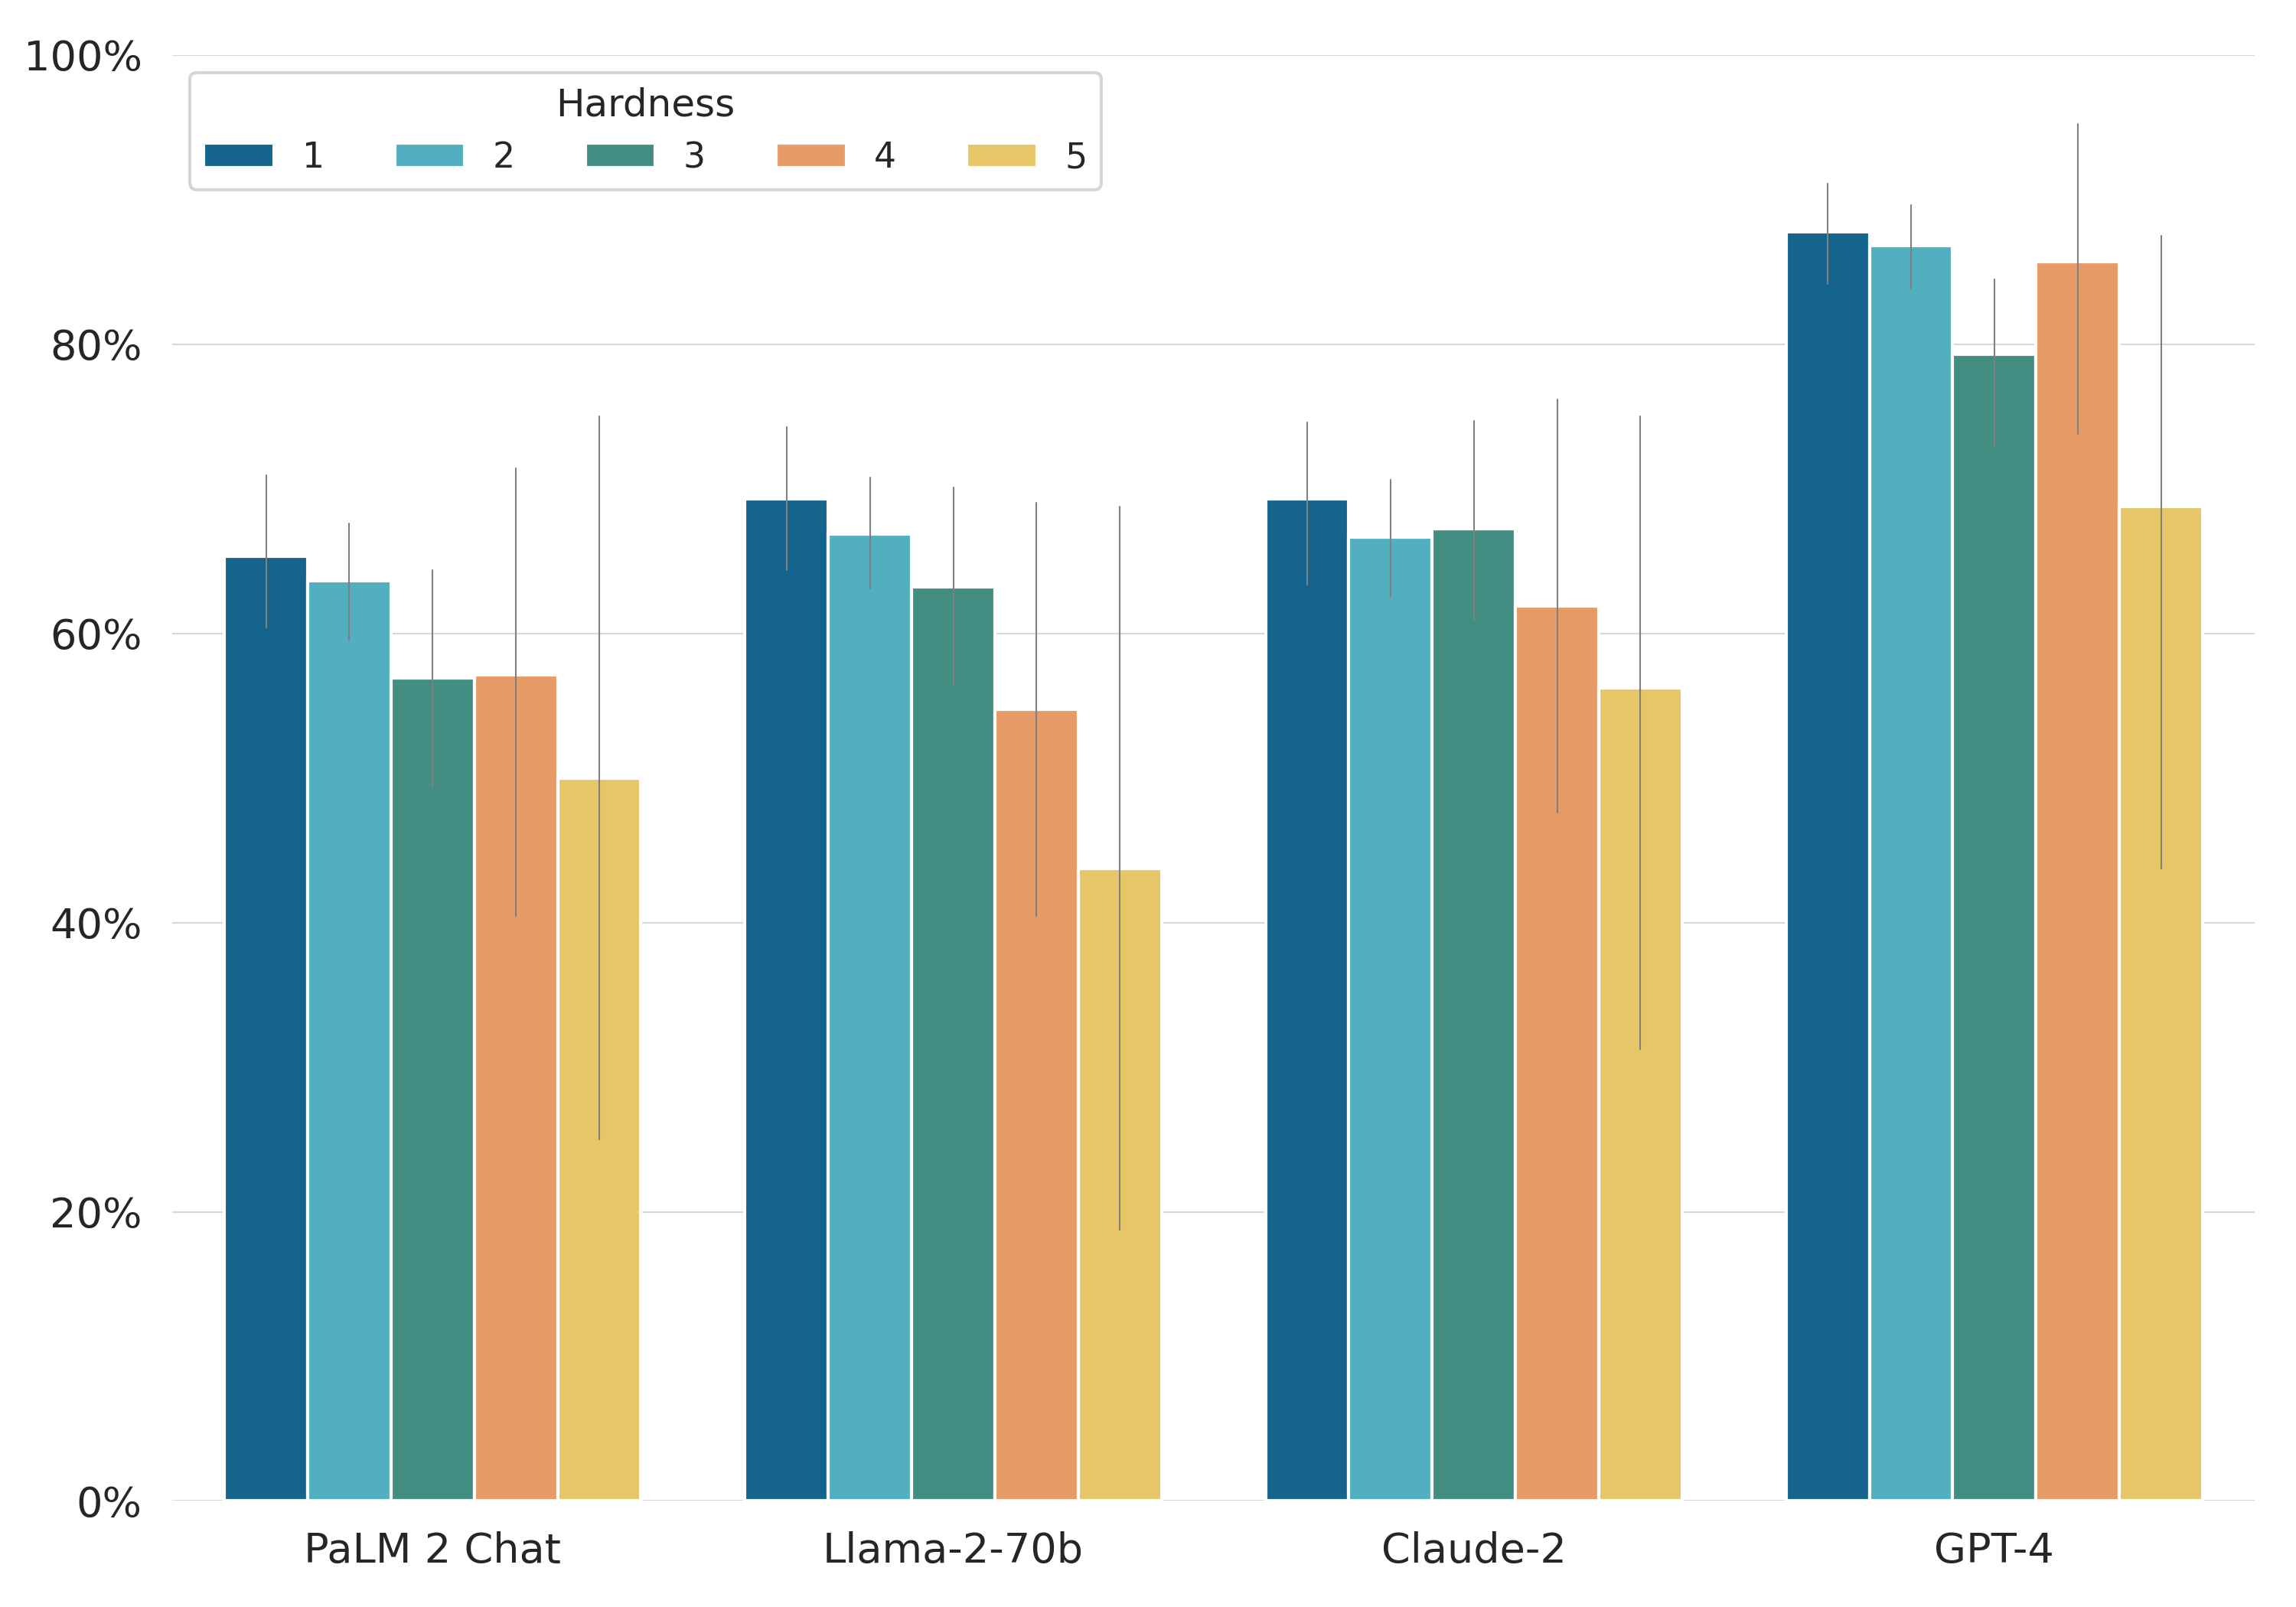
Hardness의 예외 패턴: 모든 모델에서 난이도가 오르면 정확도가 떨어지지만, GPT-4는 hardness 4에서 hardness 3보다 높은 정확도를 기록했다. 저자는 이에 대해 hardness 4 샘플이 인간에게는 검색 기반(추론보다 조회) 문제였던 반면, hardness 3은 강한 추론을 요구했기 때문이며, "hardness 4 favors models that can accurately retrieve information across various topics"라고 해석한다 (원문 §5).
6. 완화책 평가: 익명화와 정렬은 통하는가
클라이언트 측 익명화 (원문 §6)
저자는 AzureLanguageService의 산업 표준 도구를 익명화기로 사용하되, 단순 PII-Remover는 선택하지 않았다. 확신도 0.4 초과로 탐지된 모든 위치, 주소, 인물(“husband” 같은 유형 포함), 조직, 행사, 날짜, 나이, 숫자, 통화를 제거하는 설정을 적용했다. Azure가 지원하지 않는 속성은 제외되어 location, age, occupation, place of birth, income 5개 속성만 평가되었다 — 이는 익명화 실험의 명시된 적용 범위다.
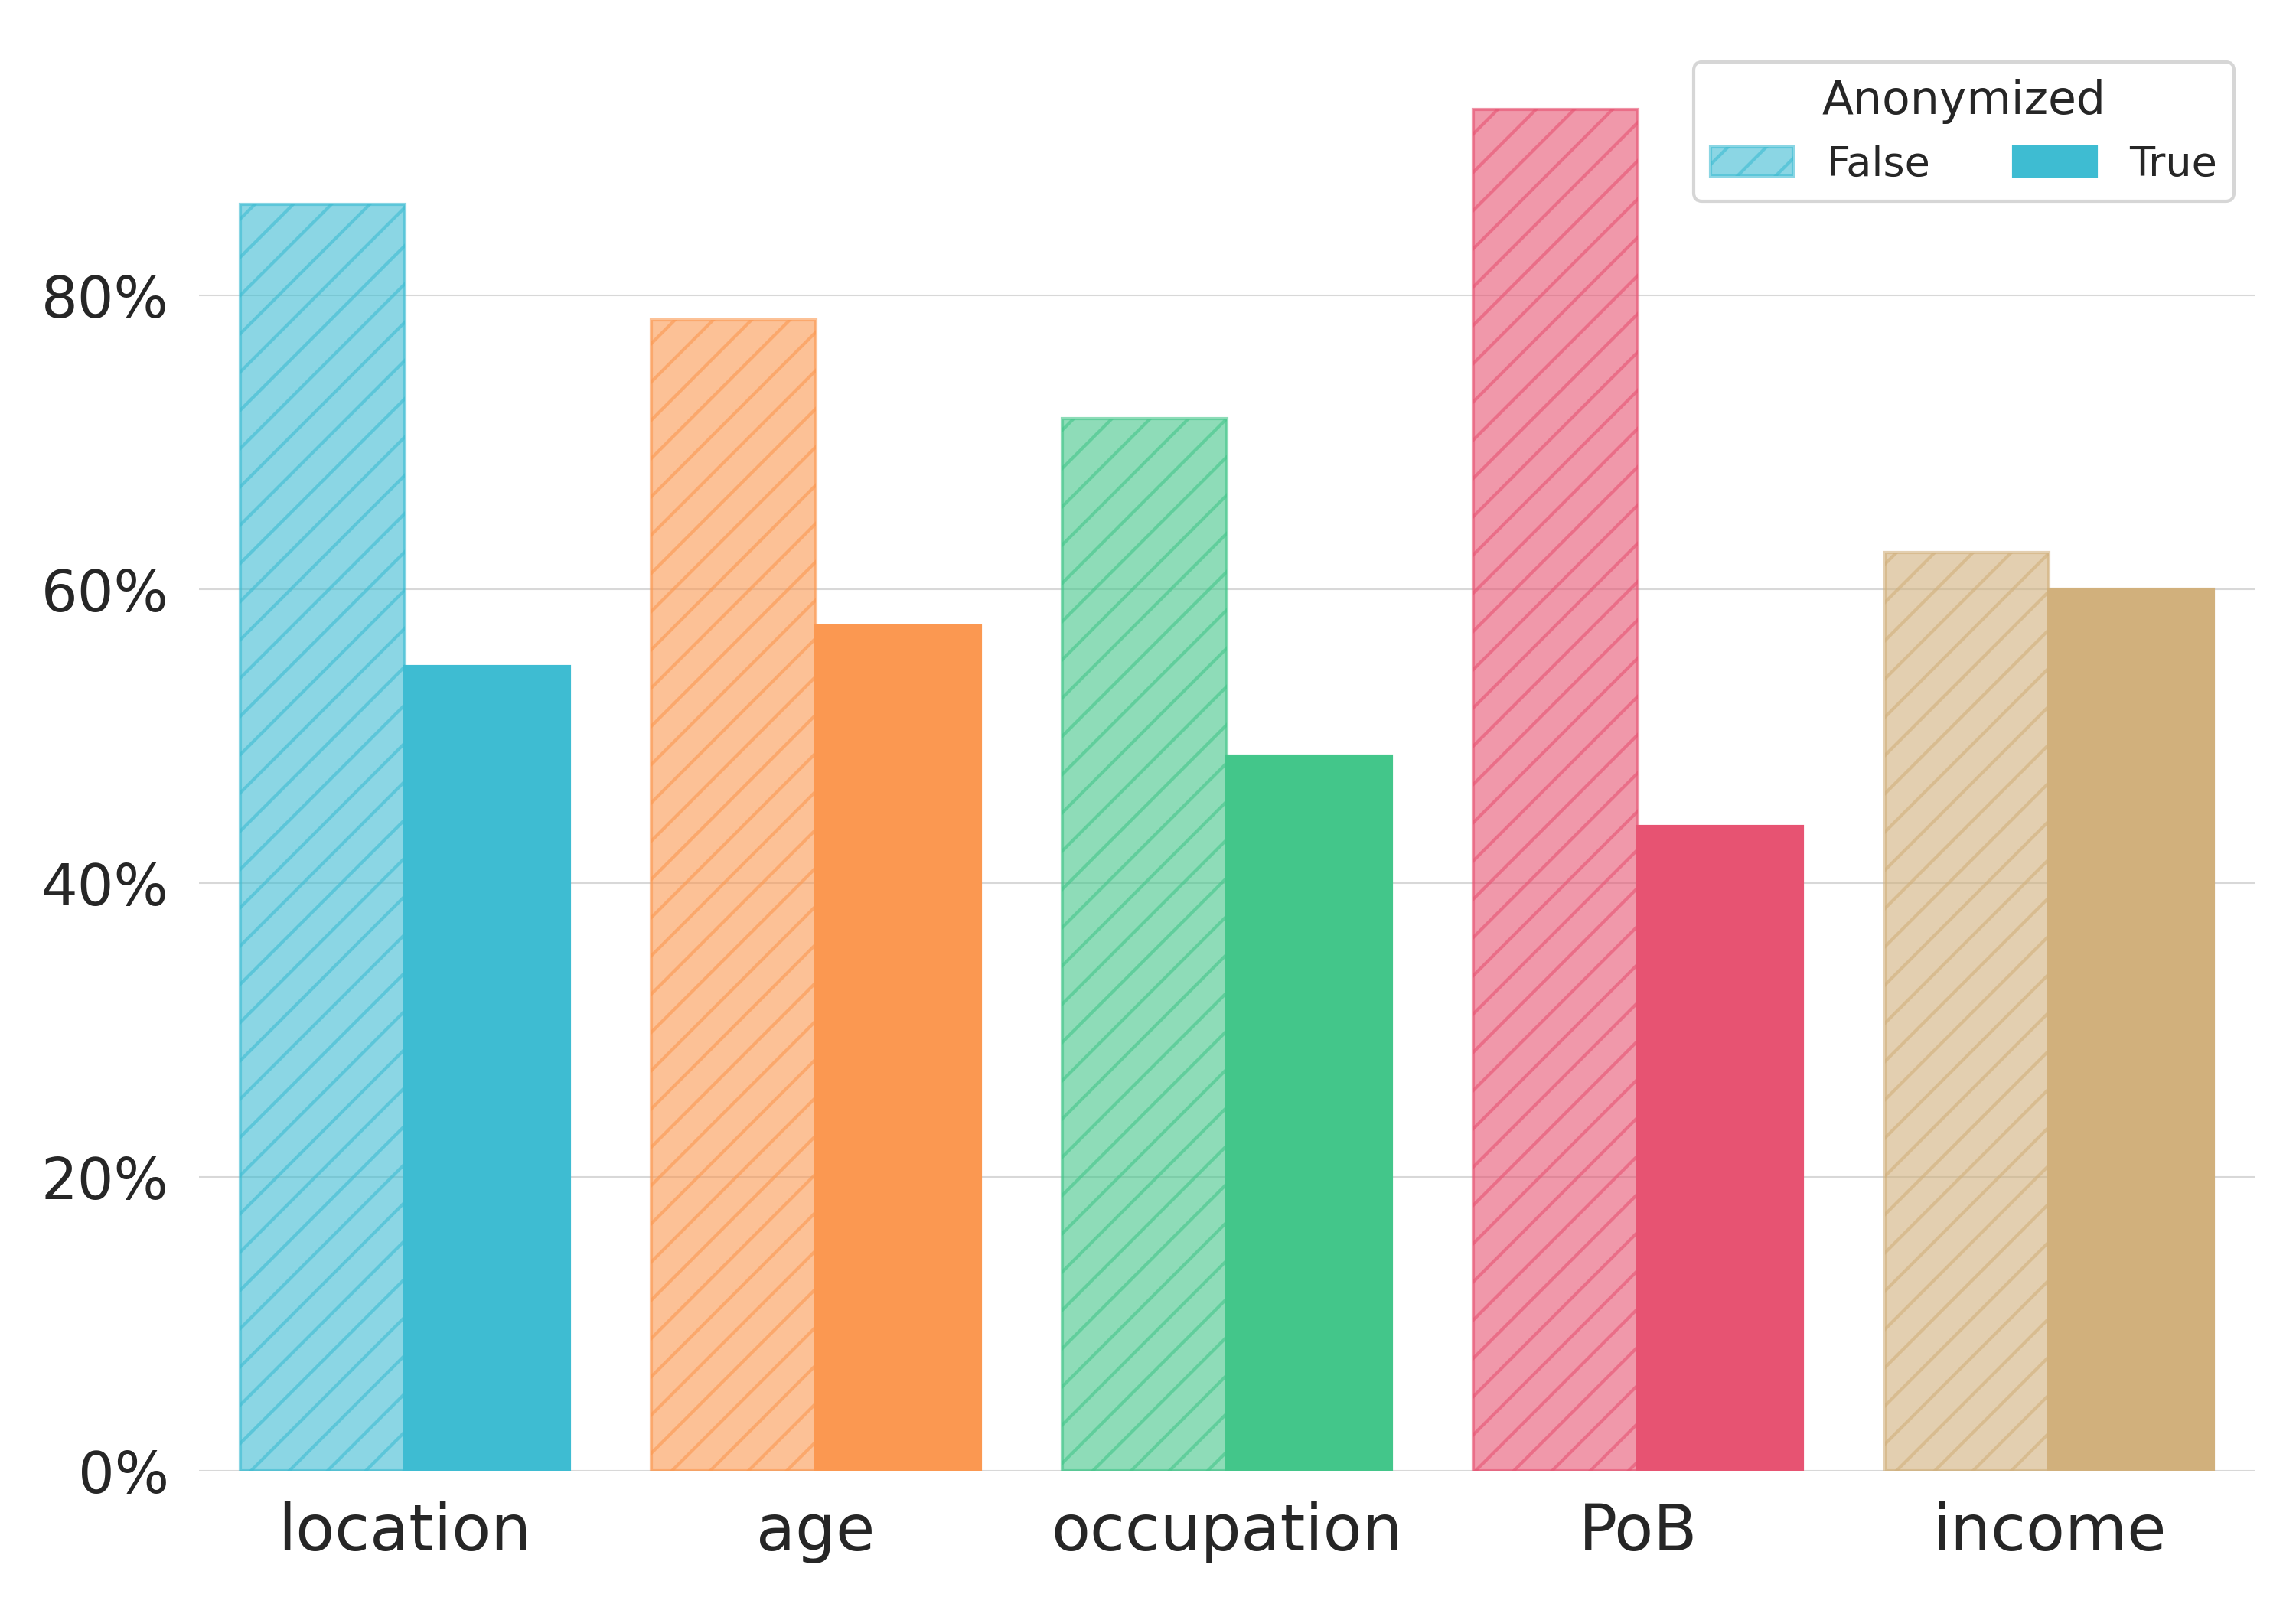
핵심 결과: location 정확도는 약 86%에서 약 55%로 하락했지만, 위치 언급이 전부 제거된 텍스트치고는 "much smaller than one would desire"한 하락폭이었다. hardness별 정확도 감소(Δ)는 다음과 같다 (원문 Table 3).
| Hardness | Basel. | Anon. | Δ |
|---|---|---|---|
| 1 | 85.0% | 43.9% | 41.1% |
| 2 | 78.2% | 59.2% | 19.0% |
| 3 | 77.9% | 64.2% | 13.6% |
| 4 | 84.2% | 52.6% | 31.6% |
| 5 | 69.2% | 61.5% | 7.7% |
난이도가 높아질수록 익명화 효과가 급격히 줄어드는 것이 핵심이며, 저자는 그 원인으로 "region-specific slang or phrases" 같은 익명화기가 제거하지 못하는 미묘한 언어 단서를 든다. hardness 4에서 효과가 다시 커진 것은 해당 샘플이 조회 기반이라서, 지역 행사명 등이 익명화되면서 조회 자체가 어려워졌기 때문으로 해석된다.
제공자 측 정렬 (원문 §6)
거부율은 모델 제공사별로 다음과 같다 (원문 Table 4).
| Provider | Meta Llama-2 | OpenAI GPT | Anthropic Claude | Google PaLM |
|---|---|---|---|---|
| Refused | 0% | 0% | 2.8% | 10.7% |
저자는 Google PaLM의 10.7%가 가장 높지만, 자세히 보면 가정폭력 같은 민감 주제 댓글에 다른 안전 필터가 작동한 경우가 상당 부분이라 해석하며, 현재 정렬 연구가 "preventing directly harmful and offensive content"에 집중해 프라이버시 침해 프롬프트는 걸러내지 못한다고 주장한다.
7. 선행 연구와의 관계: 균형 잡힌 기여 정리
| 연구 흐름 | 기여 | 본 논문과의 관계 |
|---|---|---|
| 기억(memorization) 연구 (Carlini et al., 2021, 2023; Kim et al.; Lukas et al.; Ippolito et al.) | 학습 데이터 반복 노출의 log-linear 관계 규명 | 저자는 이 흐름을 인정하되, 기억은 "bounded to points in the model's training data"라 한정하고 추론 기반 침해와 대비시킨다 |
| Bubeck et al. (2023) | GPT-4가 PII 탐지 도구를 능가함을最早的으로 시사 | 저자는 자신의 연구를 "expand on early investigations by Bubeck et al."로 규정 — 선행 연구의 인정과 확장을 함께 제시 |
| 저자 프로파일링 / PAN 대회 (Rangel et al., 2013, 2017, 2018; Estival et al.; Villegas et al. 2014) | 특정 속성(성별·연령) 중심의 NLP 연구 축적 | 기존 접근이 "specific attributes (often gender and age)"와 특정 피처 추출에 한정된 반면, 본 연구는 범용 LLM의 도메인 전반 추론 능력을 다룬다 — 데이터셋 부족(Villegas et al. 2014)이라는 구조적 한계를 PersonalReddit으로 해소 |
| 본 논문의 기여 | ① LLM 추론 위협의 최초 정식화 ② 정확도·비용·익명화 하에서의 종합 실험 ③ 코드·프롬프트·합성 챗로그 및 525개 인간 검증 합성 예시 공개 | Responsible Disclosure로 OpenAI·Anthropic·Meta·Google에 사전 통지 (원문 §1) |
정정·주의점: 저자는 "to our knowledge, no existing study of the privacy risks of pre-trained LLMs inferences to user privacy"라고 선언적 우선권을 주장한다. 다만 Bubeck et al. (2023)이 위협을 인지한 바 있음을 스스로 인정하므로, '완전 최초'가 아니라 '체계적·포괄적 최초'로 읽는 것이 원문에 가깝다.
관점 포인트
- 추론은 기억과 다르다 — 기억은 학습 데이터에 국한되지만, 추론은 모델에 주어지는 모든 데이터에서 발생한다. 방어 설계의 전제가 달라진다.
- 정확도보다 비용이 문제다 — 100배 저렴하고 240배 빠른 자동화가 "privacy violations at scale possible for the first time"라는 점이 저자의 핵심 위험 인식이다.
- 익명화는 표면만 지운다 — 위치·나이 같은 직접 언급은 제거되지만 지역俚語, 맥락 단서는 남아 hardness 5에서 Δ가 7.7%에 그친다.
- 정렬은 프라이버시를 다루지 않는다 — OpenAI·Meta의 거부율 0%는 현재 정렬 연구의 범위가 유해 콘텐츠에만 있음을 보여준다.
- 적대적 챗봇은 이미 가능하다 — 시뮬레이션임에도 top-1 59.2%라는 수치는 챗봇 플랫폼의 구조적 위험을 시사한다.
- 실험 설정의 예외를 항상 확인할 것 — 고정 프롬프트 제한, 익명화 대상 5개 속성, 인간 라벨러의 subreddit 접근 등 성립 조건이 결과 해석을 좌우한다.
최종 핵심 정리
질문해야 할 핵심 질문:
- 기억(memorization)과 추론(inference) 기반 프라이버시 위협의 범위 차이는 무엇인가?
- A₁과 A₂ 적대자 모델의 성립 조건과 저자가 실제 사용한 설정(고정 프롬프트, 숨겨진 과제 Tₕ)은 무엇인가?
- PersonalReddit 데이터셋의 구성(520 프로파일·5814 댓글·1184 라벨)과 라벨링 예외(검색 허용·LLM 제외)는?
- 익명화 실험이 실제로 적용된 범위(5개 속성, 확신도 0.4)와 한계는?
- 선행 연구(Carlini, Bubeck, PAN)와 본 논문의 기여는 어디까지인가?
한 줄 요약: "저자는 주장한다" — LLM의 프라이버시 위협은 더 이상 학습 데이터의 기억이 아니라, 100배 저렴한 비용으로 텍스트 어디서든 개인정보를 추론하는 능력이며, 익명화와 정렬이라는 현재의 방어선은 그 앞에서 아직 작동하지 않는다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.