맥락이 곧 프라이버시다 — "필요한 정보만"을 계산 가능한 신호로 바꾼 LLM 위임 프레임워크
한 문장 요약: 이 글을 읽으면 유형 기반 PII 마스킹이 왜 과잉 노출·과잉 제거를 동시에 일으키는지, 그리고 컨텍스트 무결성(CI)을 검증 가능한 강화학습 보상으로 전환하는 DelegateCI-Bench와 GRPO 파이프라인의 핵심 구조를 이해할 수 있습니다.
1. 왜 이 주제를 알아야 하는가
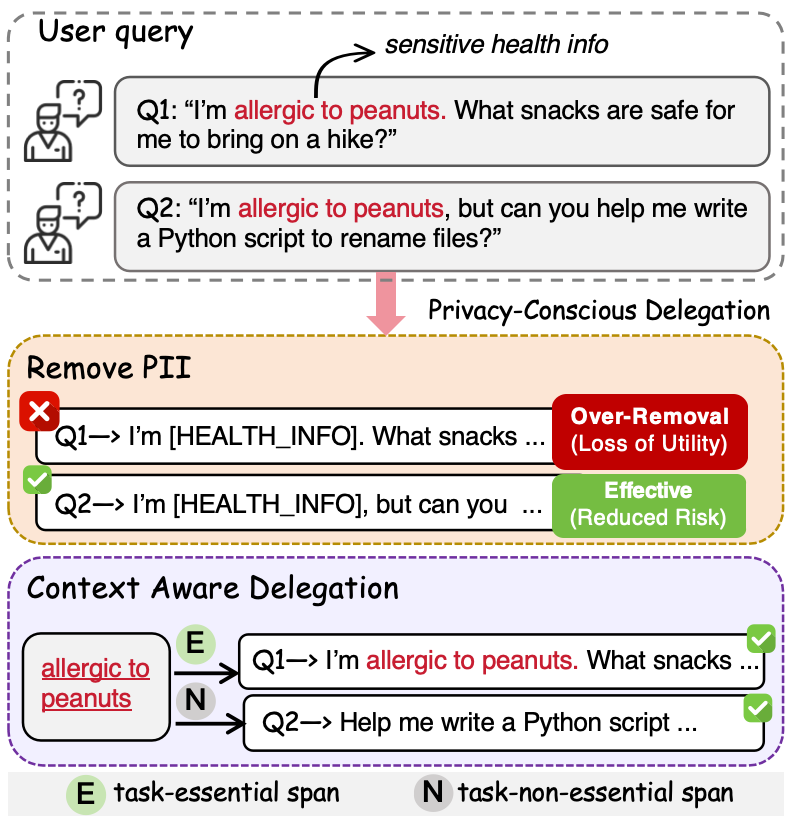
클라우드 LLM에 전송되는 사용자 쿼리는 과업과 무관한 민감 정보(건강, 가족관계, 금전, 제3자 신원 등)를 흔히 혼재한다. 저자는 이러한 원문 그대로의 전송이 "사용자가 요청한 것과 전혀 무관한 불필요한 프라이버시 노출을 만든다"고 문제를 제기한다. 기존의 유형 기반(type-based) PII 마스킹은 맥락을 무시한 채 스팬을 분류하므로, 저에 따르면 두 방향의 오류를 체계적으로 유발한다.
- over-disclosure: 비민감 맥락의 과잉 노출
- over-removal: 답변에 필요한 스팬의 과잉 제거
대표적인 예가 "땅콩 알레르기가 있다"는 문장이다. 등산용 간식을 추천해 달라는 쿼리에서는 보존되어야 하지만, Python 파일명 변경 코드를 요청하는 쿼리에서는 제거되어야 한다. 같은 문장, 같은 민감 유형, 다른 결론 — 판단 기준이 정보 유형이 아니라 과업 필요성이어야 한다는 것이 이 논문의 출발점이다.
2. 핵심 메시지 3가지
① 프라이버시 판단 기준을 "PII인가"에서 "과업에 필요한가"로 옮긴다 저자는 Nissenbaum(2010)의 Contextual Integrity(CI)를 지침으로 삼는다. CI의 5개 파라미터(송신자, 수신자, 주체, 정보 유형, 전송 원칙)를 Privacy-Conscious Delegation에 대응시키면 사용자, 원격 LLM, 정보가 되는 사람, 민감 속성, 과업 필요성이 된다. 저자는 "a span should be disclosed to the remote model if and only if that model needs it to provide effective task support"라고 운영화의 기준을 명시한다.
② (E, N) 분할을 "검증 가능한 RL 보상"으로 전환한다 각 샘플은 상호 배타적인 두 스팬 집합 — 전송 필수 E, 제거·일반화 필요 N — 으로 주석된다. 저자는 이 분할을 그대로 시퀀스 수준 보상으로 치환해 GRPO로 학습한다. 프라이버시는 하드 제약(위반 시 보상 하한 포화), 필수 정보 보존은 오목 지수로 평활화된 보상, 길이는 reward hacking 방지 페널티로 다룬다.
③ 단일 리라이터 체크포인트를 서로 다른 다운스트림 어그리게이터에 공유한다 저자는 "단일 리라이터 체크포인트를 다양한 다운스트림 어그리게이터에 공유"함으로써 백본 무관·맥락 의존적 공개 정책을 달성했다고 주장한다. 실험에서 이 구조는 온디바이스 베이스라인 대비 평균 유틸리티 최대 +10.1 향상으로 나타났다.
3. 문제의 구조 — 같은 스팬, 다른 결론
| 구분 | 유형 기반 PII 마스킹 | 맥락 인식 위임 (본 연구) |
|---|---|---|
| 판단 기준 | 정보 유형(PII 여부) | 과업 필요성 |
| 처리 단위 | 유형별 플레이스홀더 치환 | 스팬 단위 E/N 분할 |
| 주요 실패 | over-disclosure + over-removal 동시 발생 | E·N 분할 오류에 좌우 |
| 대표 사례 | "땅콩 알레르기"를 항상 제거 | 간식 추천은 보존, 코드 요청은 제거 |
문제 설정은 단일 스텝 컨텍스추얼 밴딧으로 프레이밍된다. 정책 모델 πθ가 사용자 쿼리 x에서 정제된 쿼리 y를 생성해 신뢰할 수 없는 외부 검색기·원격 LLM에 전송하고, 외부 응답은 다시 신뢰 영역에서 원래 x와 결합되어 최종 답변이 만들어진다. 저자에 따르면 다운스트림 답변자는 동결되어 최적화 루프에 포함되지 않는다.
4. DelegateCI-Bench — 3,167개 샘플은 어떻게 만들어졌나
저자는 기존 프라이버시 벤치마크가 "PII 중심이며 민감성을 정보 유형의 속성으로 취급한다"고 평가하며, 이를 보완하는 세 구성 요소로 벤치마크를 설계한다.
| 구성 | 규모 | 구축 방식 | 성격 |
|---|---|---|---|
| General (역합성) | 2,217개 | 샘플러–생성기–판별기 폐루프로 (E, N) 분할을 먼저 고정 후 표면 쿼리 생성 | 라벨이 구조적으로 정확(correct by construction) |
| WildChat OOD | 345개 | 352K 대화 → ~50K 단일턴 필터링 → GPT-4o-mini 656개 선별 → GPT-4o 주석 | 실제 사용자 분포의 진정성·강건성 검증 |
| Medical | 950개 | HuatuoGPT-o1 코퍼스 기반 보드시험형 문항, CoT 해답으로 E 추출 | over-removal 스트레스 테스트 |
- 총계: 3,167개 샘플
- 통계: General 평균 |E|=3.94, |N|=4.78, 98.3단어 / Medical |E|=3.83, |N|=3.34, 89.3단어
역합성(reverse synthesis)이 중요한 이유. 저자는 선행 연구(Ngong et al., 2025)가 필터링된 단일턴 ShareGPT 11,305개 대화에서 과업 무관 민감 정보를 포함한 쿼리를 2,849개밖에 찾지 못했다며, 이런 희소성 때문에 합성이 필요하다고 논리를 세운다. 동시에 합성 데이터가 실제 분포를 이탈하지 않도록 WildChat 검증 부분집합을 별도로 둔다.
구축 세부 설정 (저자가 실제 사용한 값): - 5축 샘플러: Domain 11개, Task type 20개, Sensitive attribute 30개, Subject 5개, Disclosure style 4개 - Confusion injection ρ=0.15: SHARED-ATTRIBUTE 60% + OVER-REMOVAL-TRAP 40% 혼입 - Generator = Claude Sonnet 4.6 (temp 0.95), Judge = GPT-4o (temp 0.0), Reformulator = GPT-4o (temp 0.2) - 수용 규칙: φ = min(r̂_E, r̂_N) ≥ 0.8이면 PASS, 0.5~0.8은 SOFT-FAIL(하드 마이닝용), 미만은 HARD-FAIL — 실제 수율 PASS ≈ 85%, HARD-FAIL < 5%
5. 학습 방법 — GRPO 보상 설계의 성립 조건과 실제 설정
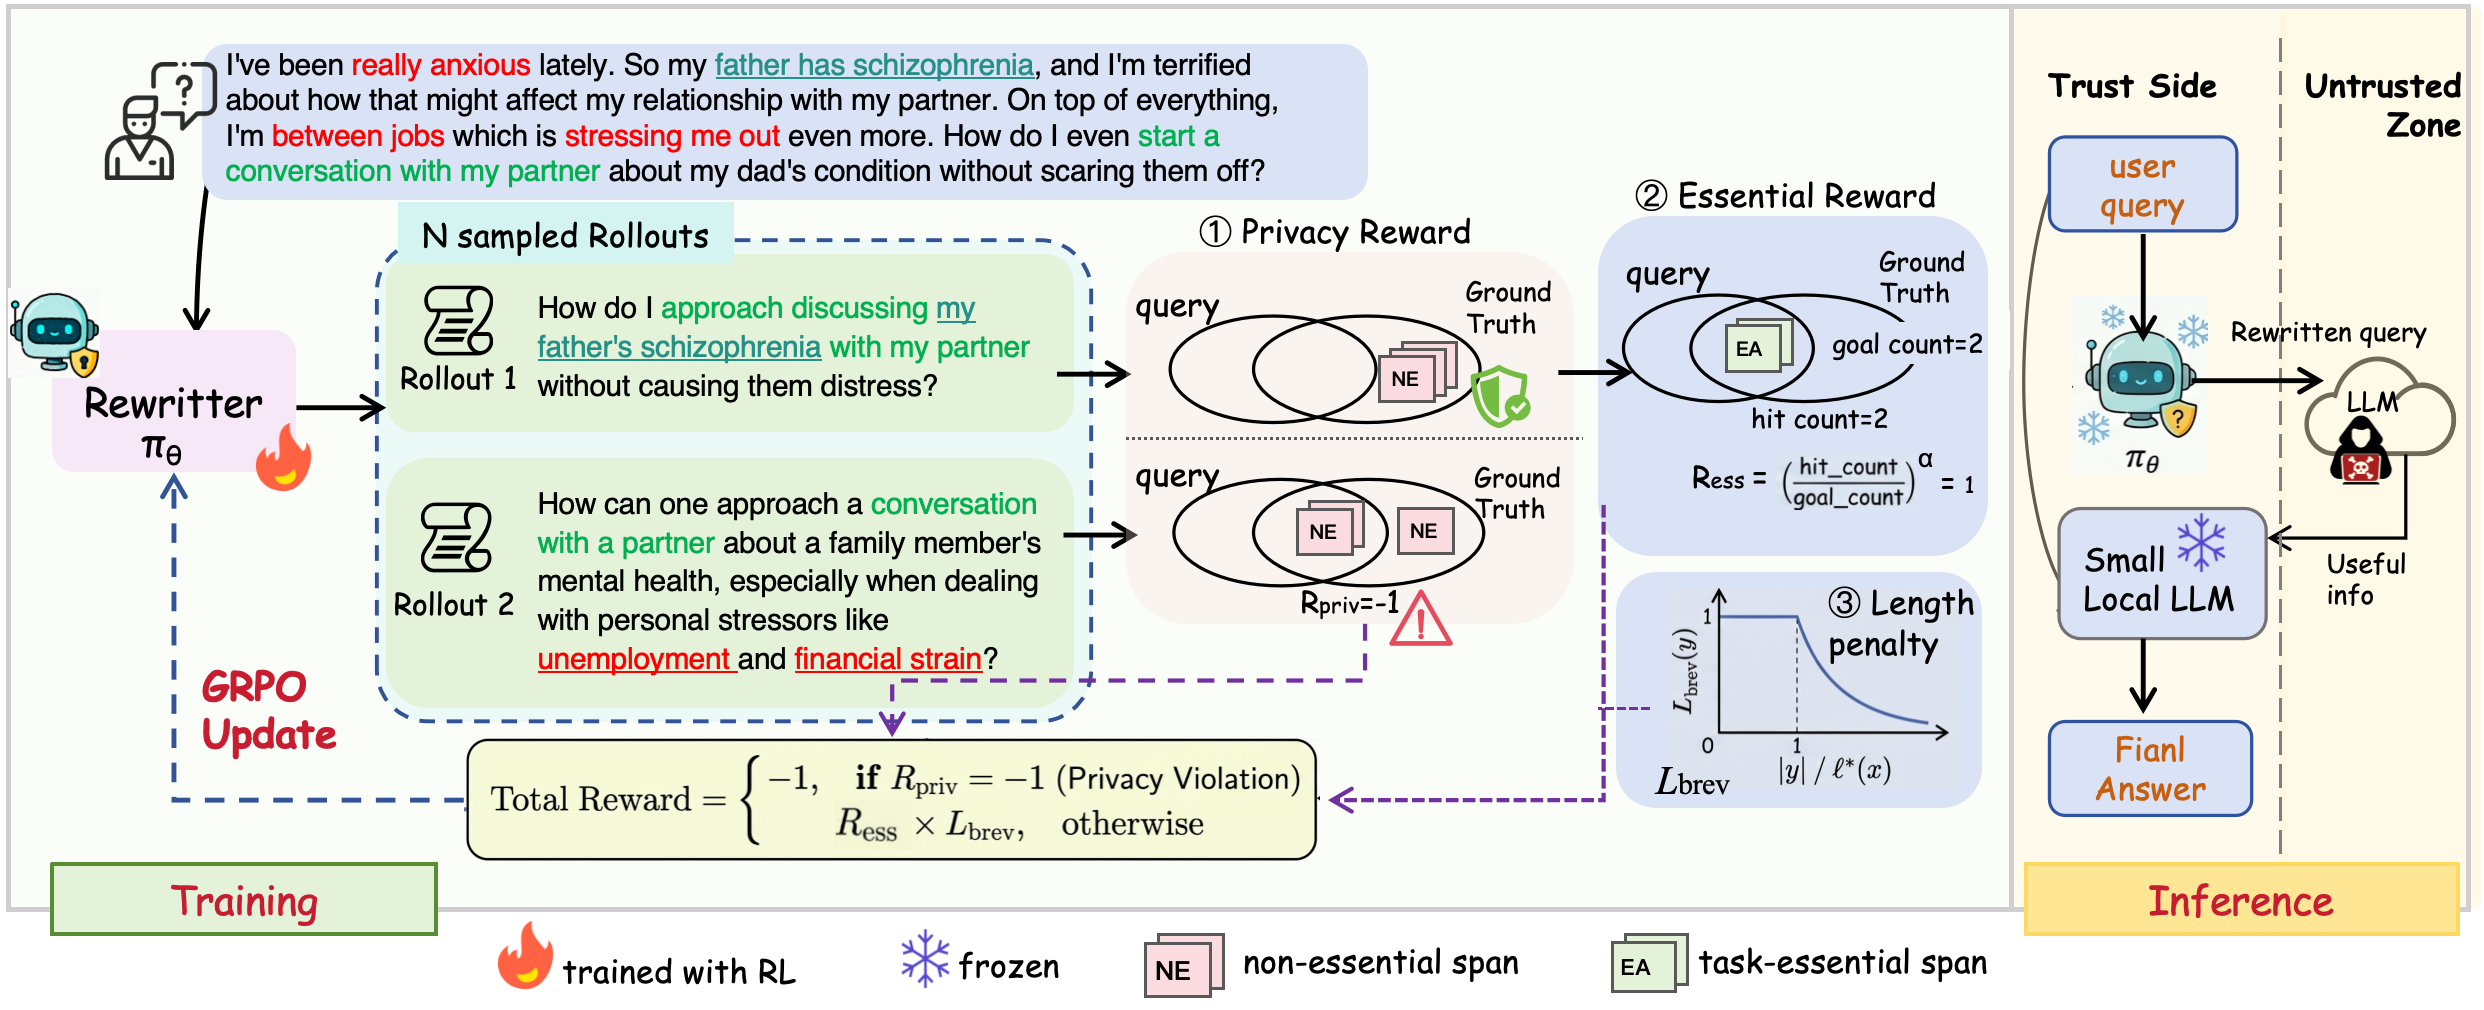
보상은 세 구성요소로 이루어진다 (§4.2).
| 구성요소 | 산식/조건 | 역할 |
|---|---|---|
| R_priv (과잉 공개) | N' 스팬 중 cov ≥ 1.0 또는 BERTScore precision > τ_priv(0.3)인 것이 있으면 −1, 아니면 0. 빈 시퀀스도 −1 | 프라이버시 하드 제약 |
| R_ess (과잉 제거) | ρ(y) = 필수 스팬 보존 비율, R_ess = ρ^α, α ∈ (0,1) | 오목 지수로 초기 학습 신호 밀도 확보 |
| L_brev (길이) | min(1, exp(1 − |y|/ℓ*)) — 목표 길이 초과 시에만 페널티 | reward hacking 방지 |
최종 보상: 유출 시 −1, 그 외에는 R(y) = R_ess · L_brev (R_priv = 0일 때).
성립 조건 유의: R_priv는 "N 스팬이 남아 있으면 무조건 −1"이 아니라 cov ≥ 1.0 또는 precision > 0.3이라는 이중 조건을 만족할 때만 발동한다. 즉 표면적 완전 복제와 근접 패럴프레이즈를 막되, 부분적·일반화 표현은 허용하는 설계다. 반면 R_ess의 오목 지수 α는 ρ < 1인 구간에서도 보상이 0으로 떨어지지 않게 하는 평활화 장치이며, 이는 "초기 학습 신호를 조밀화하기 위한" 저자의 의도에 따른 것이다.
정책 학습(§4.3): GRPO의 그룹 상대 우위 Â_i = (R_i − mean)/std + PPO 클리핑 서브로게이트 + KL 정규화. 저자가 실제 사용한 주요 설정은 다음과 같다.
- 정책: QWEN-2.5-3B-INSTRUCT, 원격: GPT-4o, 로컬 어그리게이터: QWEN-1.5B/7B, LLAMA-3.1-8B
- 하드웨어: 4× NVIDIA A100 80GB, VERL + vLLM + Ray, FSDP + FlashAttention 2
- LR 1×10⁻⁶ (3% linear warm-up), weight decay 0.01, PPO clip 0.2, KL 계수 0.005(policy loss에만 적용), n=8 rollouts/prompt, temperature 0.7
- 컨텍스트: prompt 1,024 / response 512 토큰, 최대 10 epochs, 80 optimizer step마다 검증으로 best checkpoint 선택
6. 실험 결과 — 베이스라인과의 비교
베이스라인 4종 (모두 동일한 원격 모델 GPT-4o·동일 평가 프로토콜, 로컬 구성요소만 차이):
| 베이스라인 | 방식 | 성격 |
|---|---|---|
| Presidio (Microsoft, 2021) | 규칙·NER 탐지 → placeholder 치환 | 유형 기반 대표 |
| PAPILLON (Siyan et al., 2025) | 프롬프트 기반 2모듈(Prompt Creator + Information Aggregator), 학습 없음 | 동일 위임 패러다임 선행 연구 |
| PUFT (Ngong et al., 2025) | 컨텍스트 식별 → 민감 분류 → 프롬프트 재구성 3단계 | E/N 분류 선행 연구 |
| Direct LLM / Local Only | 무변경 전송 / 로컬 전용 | 유틸리티 상·하한 참조 |
주요 결과 (Table 3)
- Ours가 모든 어그리게이터 블록에서 최고 평균 유틸리티: 최대 80.5 (LLAMA-3.1-8B), Local Only 대비 +12.5 (QWEN-1.5B)
- Medical: QWEN-7B 47.3 → 62.0, LLAMA-8B 60.7 → 66.7 (PUFT 62.8 대비 우위)
- SLR(유출률): Ours 8.0(General) / 4.2(Medical)로 PAPILLON·PUFT 대비 우위
유형별 실패 분석 (Table 4) — 저자는 두 선행 체제가 정반대의 약점을 보인다고 해석한다.
- Presidio: direct_leak 51.8%로 최고 (식별자·진단명·기기명 미처리)
- PAPILLON: direct_leak 15.8%로 낮으나 공격적 패럴프레이즈가 combination_leak 50.8%로 이어짐
- 본 방법: 심각한 누출(direct+semantic) 최저, 다중 이슈 프라이버시 실패 4.2% (비교군 7.2% / 12.2% / 6.9%)
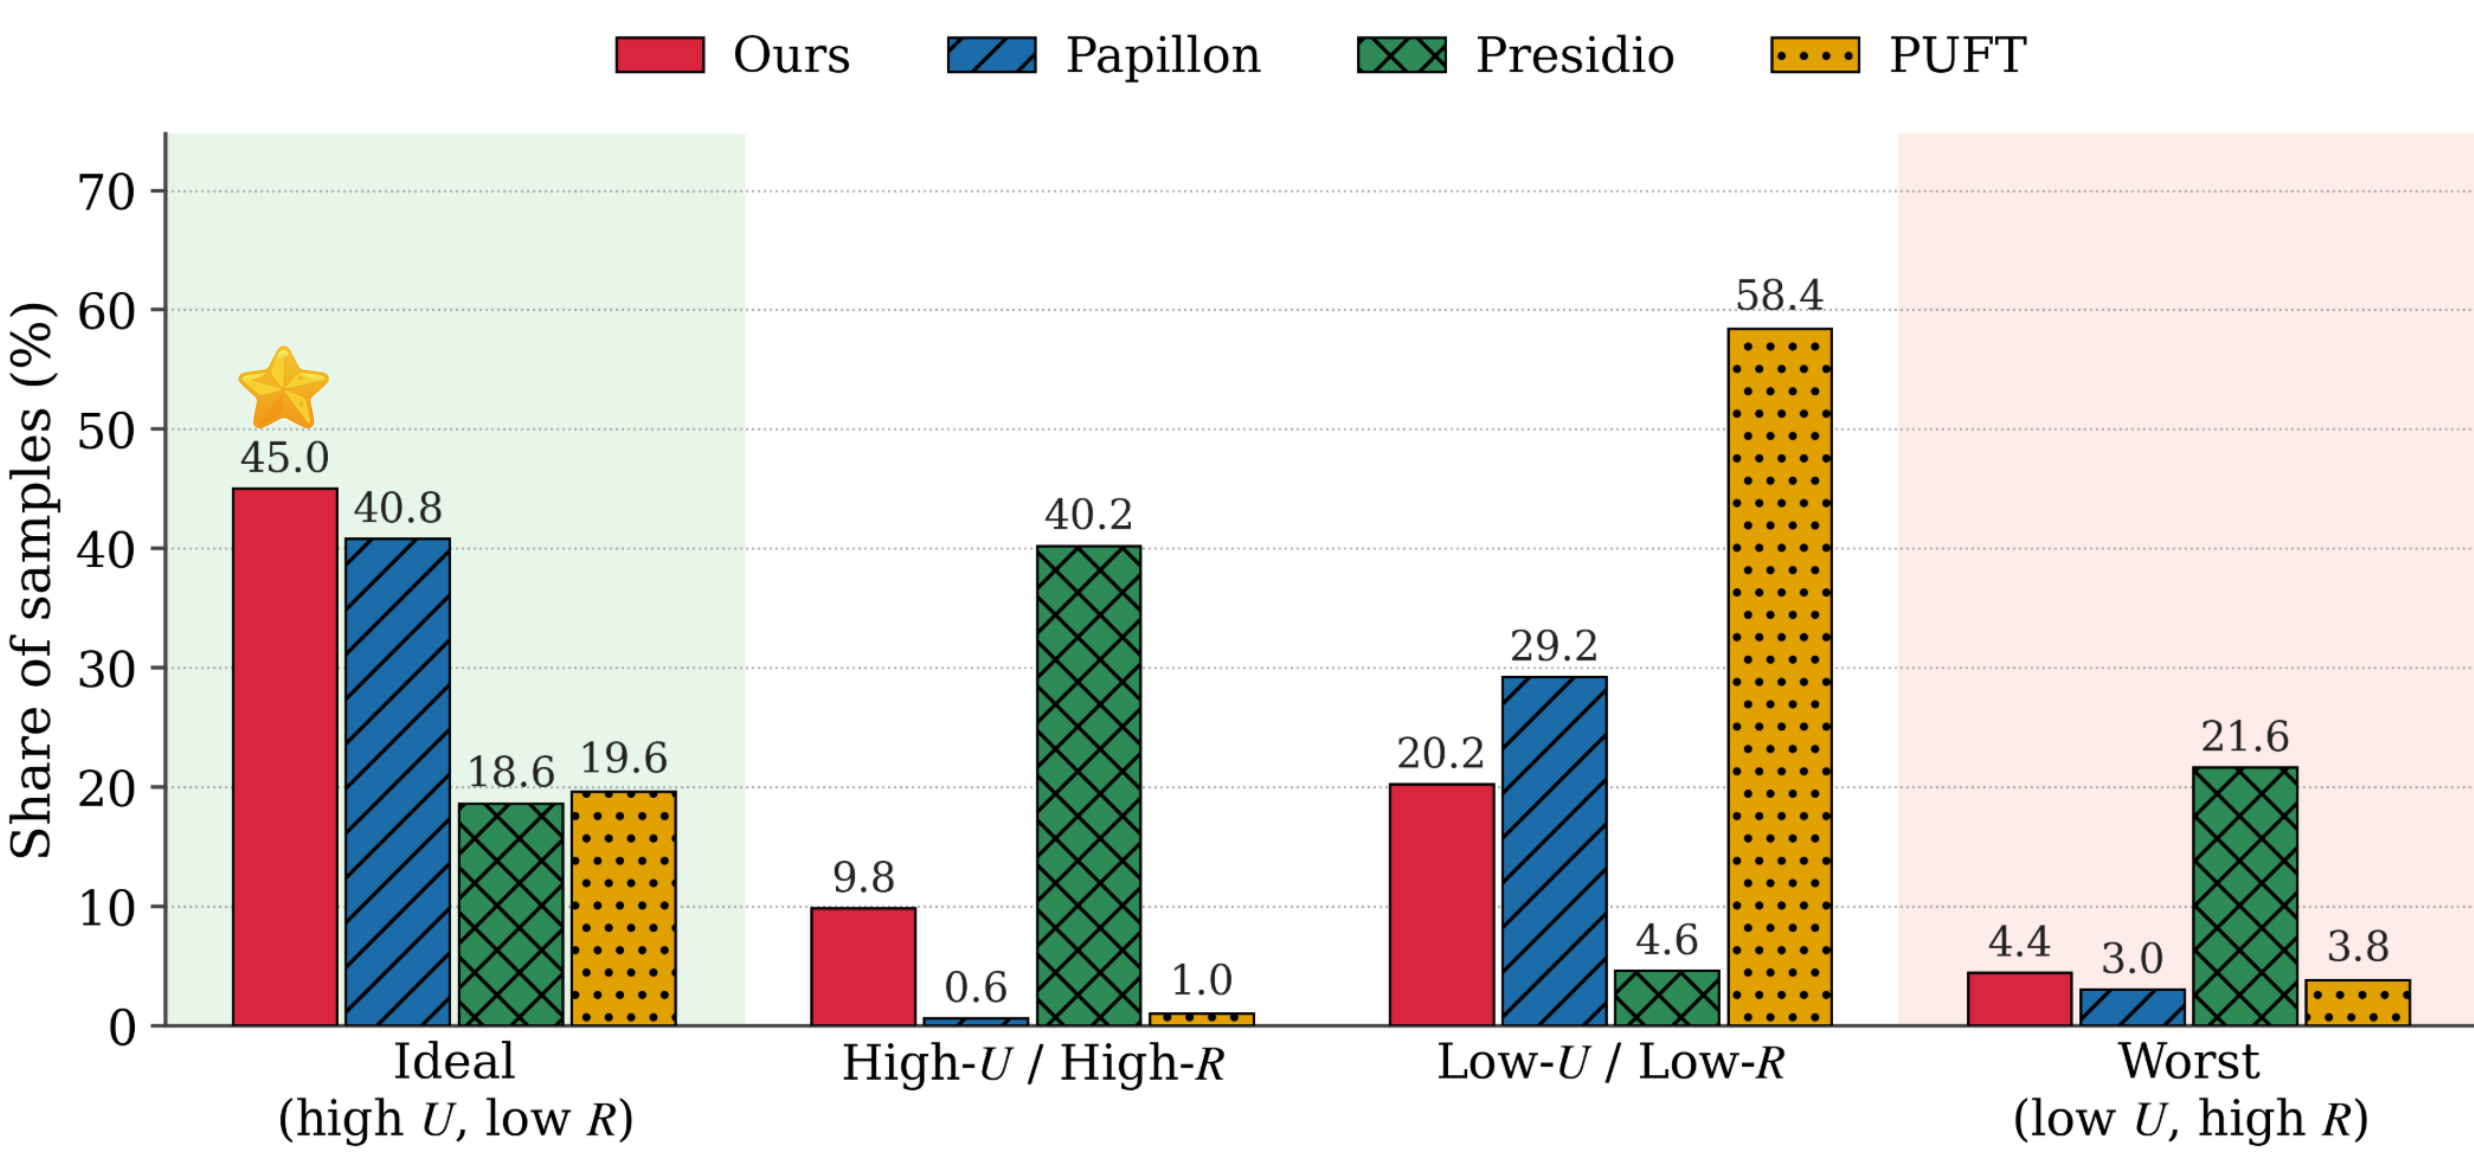
LLM-as-a-Judge (§5.3): GPT-4O-MINI(temp 0.1, JSON 모드)가 유출 4유형(direct/semantic/inferential/combination_leak)과 유틸리티 이슈 5유형을 판정한다. 저자에 따르면 재식별 위험 r과 유틸리티 u는 Pearson −0.43의 음의 상관을 보이며, Ours는 이상적 사분면(u > 0.7, r ≤ 0.5)에 11.2%, 최악 사분면에 3.6%(Presidio 9.0%의 절반 미만)가 분포한다. 평가 편향 통제로 격리 제시·블라인드 평가·장황함 편향 억제를 명시했다.
보상 어블레이션 (Table 6, LLAMA-3.1-8B) — 보상이 단순 선형 트레이드오프가 아니라 제약 조건부 목표임을 보여준다.
| 설정 | Gen 유틸 | Med 유틸 | Medical SLR | Medical EA | 해석 |
|---|---|---|---|---|---|
| Full reward | 94.3 | 66.7 | 4.2 | 71.0 | 균형 |
| w/o R_priv | 79.1 | 83.0 | 6~8배 급증 | 최고치 | over-disclosure |
| w/o R_ess | — | 29.9 | 최저 | 절반으로 감소 | over-removal (71.0→29.9) |
사례 연구 (Table 5): Case 1은 성공 — 조현병 아버지와 관련한 핵심 임상 맥락을 보존하면서 부수적 자기노출을 제거했다. Case 2는 실패 — 원문에 없는 "pet Chihuahua"를 무근거로 도입했다. 저자는 전체 재작성의 7.2%가 원 질문에 근거 없는 민감 속성을 도입한다며, 이를 본 방법 6.6%, PAPILLON 9.2%로 방법론 전반의 일반적 위험으로 기술한다.
7. 선행 연구와의 관계 — 균형 잡힌 위치
저자의 서술을 그대로 옮기면 다음과 같다.
- 입력 익명화/차분 프라이버시 계열: 정의된 민감 범주에만 작동하므로 자유형 요청으로 확장 불가
- Siyan et al. (2025, PAPILLON): 동일한 위임 패러다임을 다루지만 프라이버시를 PII 누출로 환원
- 기존 CI 벤치마크: 주로 출력 측(부적절 수신자 전달)을 진단 — 본 연구는 입력 측 span 수준 (E, N) 분할로 과잉 노출·과잉 제거를 최초 공동 평가했다고 주장한다
다만 저자가 스스로 인정하는 후속·경쟁 기여도 있다. PAPILLON·PUFT는 본 논문의 직접 비교 대상이자, E/N 분류·로컬 중개라는 문제 설정을 먼저 제시한 선행 연구다. 논문은 이들을 "무시"하지 않고 동일 원격 모델·동일 평가 프로토콜 아래 스윕(QWEN-1.5B/7B, LLAMA-3.1-8B)으로 공정 비교한다.
저자가 명시한 한계 2가지:
- CI 운영화의 범위: 단일 수신자(원격 LLM)·단일 전송 원칙(작업 필요성) 기반의 이진 분할에 그친다 — 등급화·역할·목적 의존적 CI 규범, 다중 턴 규범 진화, 재공유·사회적 맥락은 모델링하지 않는다.
- R_priv 설계의 취약점: 어휘 커버리지·BERTScore precision 기반이라 표면/근접 패럴프레이즈에는 민감하나 (i) 추론적 누출, (ii) 교차 쿼리 연계·종단적 재익명화에는 취약하다.
8. 관점 포인트 — 실무자가 짚어야 할 것
- 민감 유형 목록이 아니라 과업 필요성 목록을 먼저 정의하라 — E/N 분할이 선행이고 마스킹은 후행이다.
- 하드 제약과 평활화 보상을 분리하라 — 어블레이션에서 R_priv 제거 시 SLR이 6~8배 급증했고, R_ess 제거 시 Medical 유틸이 71.0→29.9로 붕괴했다.
- 길이 페널티는 초과분에만 적용하라 — 목표 길이 이하에는 penalty가 없는 exp 기반 설계가 reward hacking을 막는다.
- 합성 데이터는 진정성 검증 세트와 짝을 지어라 — 역합성 라벨의 정확성과 WildChat의 실제 분포 검증을 분리해 운용한다.
- 평가를 블라인드로 하라 — 격리 제시·출처 비공개·장황함 편향 억제가 LLM-as-a-Judge의 신뢰성을 좌우한다.
9. 최종 핵심 정리
발표·검토 전 아래 질문을 확인해 보자.
- 프라이버시 판단 기준이 유형인가, 과업 필요성인가?
- (E, N) 분할이 검증 가능한 보상 함수로 치환되었는가?
- 프라이버시 보상이 하드 제약(−1 포화)으로 동작하는가?
- 필수 정보 보존 보상에 오목 지수 평활화가 있는가?
- 벤치마크에 실사용자 OOD 슬라이스와 과제 스트레스 세트가 함께 있는가?
- 평가가 블라인드·격리 조건으로 수행되었는가?
- 한계(추론적 누출, 교차 쿼리 연계, 다중 턴 CI 규범)가 명시되어 있는가?
한 줄 요약: "무엇을 지울 것인가"가 아니라 "원격 모델이 무엇을 알아야 하는가"를 계산 가능한 보상으로 정의했을 때, 프라이버시와 유틸리티는 서로를 깎지 않는 제약 조건부 목표가 된다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.