PAPILLON 논문 해설: 추론 시점에 PII를 처음부터 노출하지 않는 위임 파이프라인
한 문장 요약: 이 글을 읽으면 NAACL 2025 논문 "PAPILLON"이 제안하는 Privacy-Conscious Delegation 과제, 벤치마크 PUPA, 파이프라인 PAPILLON의 구조와 핵심 실험 수치를 이해할 수 있습니다.
1. 왜 이 주제를 알아야 하는가
ChatGPT 등 LLM이 치료·교육·의료 등 민감 영역에 확산되면서 추론 시점(inference-time) 개인정보 유출이 심각한 우려로 대두되었다. 저자들에 따르면 기존 연구는 학습 데이터 기억화에 초점을 맞췄으나, 학습 데이터를 위생화하는 것만으로는 사용자가 추론 시점에 노출하는 PII(개인식별정보)를 막을 수 없다 [원문 p.1].
기존 대안에도 각각 한계가 있다.
- 단순 텍스트 레댁션(redaction): 응답 유틸리티를 떨어뜨린다 — 이력서 기반 지원서를 작성할 때 관련 개체 정보가 지워지면 활용도가 낮아진다.
- 로컬 호스팅 오픈소스 모델: 프라이버시는 지키지만 API 기반 프론티어 모델 대비 생성 품질이 뒤처진다.
이 배경에서 저자는 Privacy-Conscious Delegation 과제를 제안한다: 신뢰할 수 있으나 약한 모델(M_LOCAL, 오픈소스/사내)이 신뢰할 수 없으나 강한 모델(M_REMOTE, 프로퍼ietary API)을 '도구'로 사용하는 위임 패러다임으로, 차분적 프라이버시가 아니라 처음부터 비신뢰 LLM이 개인정보에 접근하지 못하게 하는 것이 목표다 [원문 p.1].
2. 핵심 메시지 3가지
① 과제 정의: 차분 프라이버시가 아닌 '접근 자체의 차단'
저자는 공격자 방어·차분적 프라이버시 보장 중심이던 기존 추론 시 프라이버시 연구(Hong et al. 2023의 딥 언어 네트워크, Feyisetan/Xu의 텍스트 사니타이제이션 등)와 달리 사용자 중심 접근을 취한다. 목표는 "LLM이 정보를 유출하지 않도록 막는 것"이 아니라, 사용자가 처음부터 PII를 공개하지 않도록 돕되 유틸리티는 유지하는 것이다. 추가 학습 없이 로컬 프록시 모델과 LLM 호출을 체인하는 가벼운 접근이라 다양한 과제에 적응 가능함을 저자는 강조한다 [원문 p.1].
② 벤치마크 PUPA: 실사용자 대화에서 PII 단위를 추출
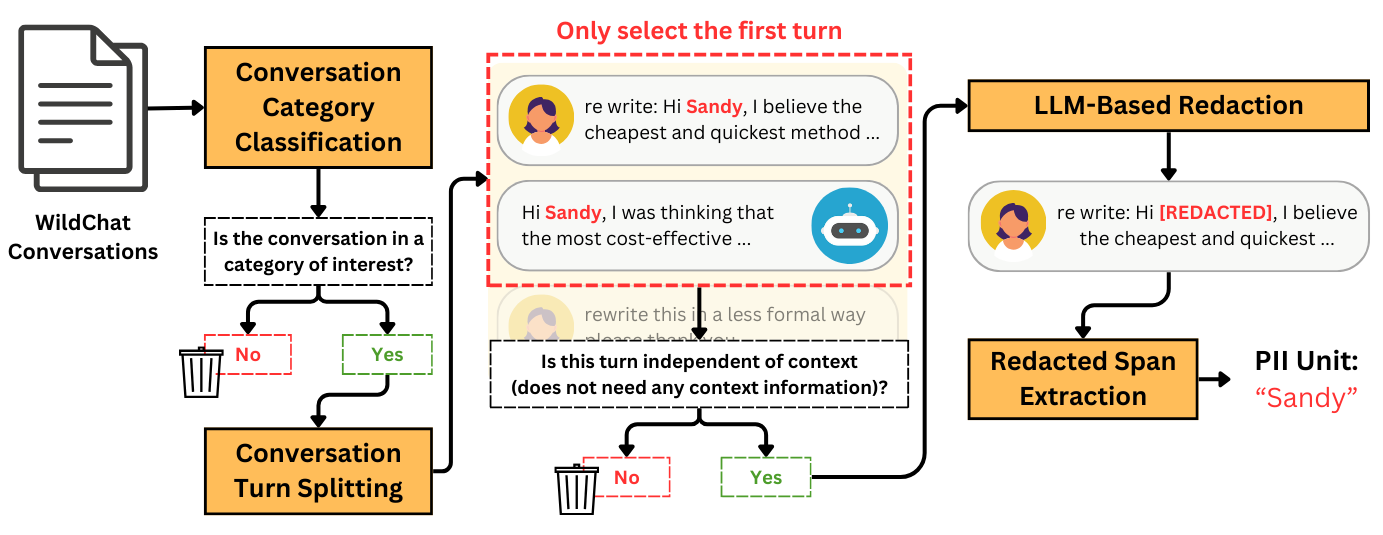
공개된 WildChat 데이터셋(사용자-ChatGPT/GPT-4 대화 100만 건)에서 901개 실사용자-에이전트 상호작용을 샘플링하고, Mireshghallah et al. (2024)의 GPT-4 주석 5,000건 중 이름·회사가 명시적으로 등장하는 3개 카테고리 — (1) Job, Visa, & Other Applications, (2) Financial and Corporate Info, (3) Quoted Emails and Messages — 를 선택했다 [원문 p.1].
③ 최적 조합: Llama-3.1-8B-Instruct(로컬) + GPT-4o-mini(독점)
최적 설정에서 응답 품질 85.5 유지, 프라이버시 유출 7.5를 달성했다. 다만 저자도 프로퍼ietary LLM 생성 품질과의 격차는 향후 과제로 남긴다 [원문 p.1].
3. PUPA 데이터셋: PII를 어떻게 뽑는가
데이터 처리 단계에서는 대화 단위 주석을 프롬프트-응답 쌍 단위로 분리하여 컨텍스트 의존 쿼리와 PII 누출 없는 턴을 제거, 최종적으로 PUPA-TNB 237턴, PUPA-New 664턴을 확보했다 [원문 p.4].
PII 추출은 3단계로 진행된다.
① LLM 레댁션(Singhal et al., 2024 프롬프트 사용 — GPT-4 recall 0.95이나 과잉 레댁션 문제)
↓
② 정규식으로 [REDACTED] 전후 텍스트 추출 (실패 시 LLM 프롬프팅 대체)
↓
③ 중복 제거
성립 조건과 예외: 긴 프롬프트(이력서 포함)에서 LLM이 직접 PII를 추출하면 누락 위험이 있어, 저자는 레댁션 우선 전략을 채택했다 — 즉 "LLM이 직접 뽑는다"가 일반형이 아니라, 실제 사용한 주 설정은 "먼저 마스킹하고 마스킹 구간만 추출하는 것"이다 [원문 p.4].
카테고리 비중은 PUPA-TNB Financial 47.26%, PUPA-New Applications 40.66%이며, 평균 PII 유닛은 3.01 / 2.86개다 [원문 p.4]. 주석 확장을 위해 GPT-4-turbo, GPT-4o-mini, GPT-3.5-turbo의 정확도를 비교했는데, 전체 카테고리 가중 평균 F-1은 0.91 / 0.84 / 0.69였다 [원문 p.1].
4. PAPILLON 파이프라인: 3단계 위임 구조
파이프라인은 아래 3단계로 구성된다 [원문 p.1].
| 단계 | 구성 요소 | 역할 |
|---|---|---|
| 1 | Prompt Creator (M_LOCAL) | PII를 제거한 프롬프트 q' 생성 |
| 2 | M_REMOTE (API 기반 LLM) | q'에 대한 응답 C_R 생성 |
| 3 | Information Aggregator (M_LOCAL) | C_R + 원본 q로 최종 응답 C_L 합성 |
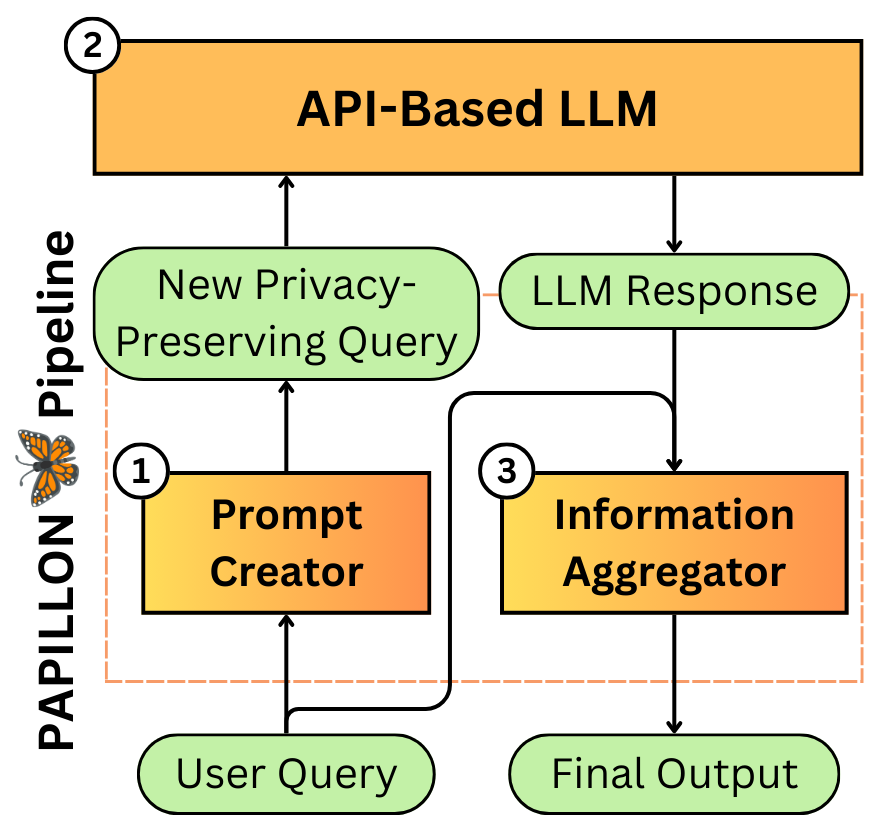
프롬프트 최적화 설정: DSPy MIPRO v2를 사용하여 PUPA-New에서 150개 학습/150개 검증, 200 trials를 수행했고, few-shot 예시는 긴 프롬프트 길이 때문에 미포함이라는 예외 조건이 있다. 최적화 목적함수는 다음과 같다 [원문 p.4].
QUAL(C_L, C_T) − LEAK(q', p_{1..n}) + PWF(q')/2
여기서 PWF는 프롬프트 적합성 지표다. 즉 품질(QUAL)을 높이면서 유출(LEAK)을 낮추는 두 목표를 한 목적함수에서 동시에 다룬다.
5. 평가 지표: QUAL과 LEAK는 어떻게 검증됐나
QUAL(품질 보존): 프로퍼ietary LLM 응답 대비 품질 동등 여부를 LLM judge로 이중 순열 판정(위치 편향 완화)한다. 부록 A의 알고리즘은 두 응답을 순서를 바꿔 비교(s1, s2)하고, 불일치 시 1을 반환하며 일치 시 s1을 반환한다 [원문 p.1]. Prolific 인간평가 50쌍(QUAL=1 26쌍)에서 QUAL=0일 때 정합률 70.8%, QUAL=1일 때 65.4%(동률 포함)로 검증되었다 [원문 p.4].
LEAK(프라이버시 유출): 원문 PII 조각이 재작성 프롬프트 q'에 포함되는 비율이다. PUPA 50개 항목(Llama-3.1-8B + GPT-4o-mini) 검증에서 다수결 기준 86% 동의, 최소 1명 동의 94%였으며, 불일치의 71.4%가 안전한 쪽 오류(거짓 양성) — 즉 프라이버시 보호 프롬프트를 누출로 오판한 경우였다 [원문 p.4].
6. 핵심 실험 결과: 최적화 전후 비교
GPT-4o-mini를 M_REMOTE로, 오픈소스 6종을 M_LOCAL로 구성해 A100 80GB에서 SGLang/VLLM 호스팅으로 평가했다(Table 4, [원문 p.7]).
| 설정 (PUPA-TNB) | QUAL | LEAK | 해석 |
|---|---|---|---|
| GPT-4o-mini [Unredacted] | 88.2 | 100.0 | 상한선 — 품질 최고·유출 100% |
| GPT-4o-mini [Redacted] | 77.2 | 0.0 | 단순 레댁션은 품질 11pt 하락 |
| Llama-3.1-8B (최적화 전) | 71.8 | 17.4 | — |
| Llama-3.1-8B (최적화 후) | 85.5 | 7.5 | QUAL +13.7, LEAK −9.9 — 최적 최고 품질·최저 누출 |
| Mistral-7B (최적화 전→후) | — | 36.9 → 11.9 | LEAK −25.0 최대 누출 감소 |
| Llama-3.2-1B (최적화 전→후) | +16.8 개선 | +11.5 악화 | 품질은 오르나 유출 악화 — 예외 케이스 |
산식 예시 (Llama-3.1-8B): QUAL 변화 = 85.5 − 71.8 = +13.7, LEAK 변화 = 7.5 − 17.4 = −9.9.
최적화 전 최고였던 Mistral-Small(85.3)은 최적화 후 QUAL 동률(0.00 변화)에 그쳤다. 저자는 텍스트 레댁션만으로는 유틸리티 손상이 크다는 점이 PAPILLON 필요성을 뒷받침한다고 본다 [원문 p.7].
M_REMOTE별 PAPILLON 성능(Table 6, [원문 p.7]): Llama-3.1-8B-Instruct 로컬 모델을 고정한 ablation에서 — GPT-4-turbo 87.4, GPT-4o 86.0, GPT-4o-mini 85.5, GPT-3.5-turbo 83.8. 비익명(직접 호출) 품질은 GPT-4-turbo 91.0, GPT-4o 86.5, GPT-4o-mini 88.2, GPT-3.5-turbo 64.3, Llama-3.1-8B-Instruct 81.5였다.
성립 조건과 예외: 저자에 따르면 M_REMOTE의 비익명 품질이 PAPILLON 품질의 상한인 경우가 많으나 예외도 존재한다(GPT-3.5-turbo) — 최적화된 Llama-3.1-8B 파이프라인(83.8)이 비익명 로컬 모델 자체(81.5)를 능가하며, 이는 PAPILLON이 M_REMOTE 출력을 효율적으로 활용함을 시사한다 [원문 p.7]. 프롬프트 최적화는 모델 크기와 무관하게 품질을 전반적으로 향상시킨다는 것이 저자의 해석이다.
7. 정성 분석과 연산 비용
정성 분석: PAPILLON은 PII를 검열하고 구체적 프롬프트를 생성하지만, 과도한 프라이버시 보호로 핵심 정보를 누락하거나 Prompt Creator가 원래 쿼리와 무관한 정보를 확장하는 문제가 있다(예: 이메일 재작성 요청에 교통수단 비용 질문 생성). SentenceTransformer(all-MiniLM-L6-v2) 코사인 유사도는 GPT-4o-mini 사용 시 평균 0.7251로, Information Aggregator가 중간 출력을 단순 복사하지 않음을 보여준다 [원문 p.7].
부록 예시들의 성패도 드러난다.
| 예시 | 시나리오 | QUAL | LEAK | 코사인유사도 |
|---|---|---|---|---|
| 예시 1 | 민감 전자장비 운송(Uber 픽업 요청 → 전문 운송사 권고로 변경) | 0.0 | 0.0 | 0.71 |
| 예시 2 | 콜드콜 스크립트 | 1.0 | 0.0 | 0.58 |
| 예시 3 | 이메일 답장 | 1.0 | 0.0 | 0.82 |
| 예시 4 | 가격 협상(이미 합의된 사항 판단 → 원본 대비 저품질) | 0.0 | 0.0 | 0.76 |
| 예시 5 | WIPRO 지원 이메일(팔로업 템플릿으로 일반화 후 최종 단계에서 정보 복원) | 1.0 | 0.0 | 0.74 |
연산 오버헤드: PII 제거로 입력 토큰이 평균 193.9토큰 감소하지만, 완성 토큰이 136.4토큰 증가한다. API 직접 사용 비용 $0.063** 대비 PAPILLON 사용 시 **$0.076로 소폭 증가하며, 저자는 이를 프라이버시 보호를 위한 적은 비용으로 평가한다 [원문 p.7].
8. 선행 연구와의 관계, 그리고 한계
선행 연구와의 차별점(저자의 위치 설정):
| 연구 | 접근 | 본 논문과의 차이 |
|---|---|---|
| Hong et al. 2023, Feyisetan/Xu 텍스트 사니타이제이션 | 공격자 방어·차분적 프라이버시 보장 | 본 논문은 사용자 중심, 추가 학습 없는 프록시 체인 |
| PrivacyLens (Shao et al. 2024) 등 기존 벤치마크 | 합성 데이터 | 본 논문은 실사용자 대화(WildChat) 기반 |
| Mireshghallah et al. (2024) | GPT-4 주석 5,000건 | 본 논문은 이를 3개 카테고리로 재선별·분할하여 PUPA 구축 |
한편 저자는 Mistral-Small의 높은 유출이 Shao et al. (2024)의 모델별 프라이버시 규범 인식 차이와 일치한다고 해석한다 — 국적·회사명보다 인명에 더 민감하고, 1인칭 맥락이 아닌 PII(예: 번역 요청)에서 프라이버시 인식이 낮다는 관찰이다 [원문 p.7].
저자가 스스로 밝힌 한계:
- 명시적 PII가 공개된 쿼리에 한정되어 있음
- LLM 기반 지표(QUAL/LEAK)에 의존
- PAPILLON의 비직관적 프롬프트 생성 문제
향후 과제: 차분 프라이버시의 이론적 보장 및 소형 프라이버시 인식 모델 개발을 목표로 한다고 저자는 밝힌다. 데이터·코드는 github.com/Columbia-NLP-Lab/PAPILLON에서 공개되었다.
9. 독자가 짚어야 할 실무 포인트
- 레댁션은 품질 비용이 크다 — GPT-4o-mini 기준 QUAL 88.2 → 77.2로 11pt 하락. PII 마스킹만으로는 유틸리티를 못 지킨다.
- 위임 구조의 핵심은 Information Aggregator — 원본 쿼리 q를 다시 받아 PII를 복원하기 때문에, 코사인 유사도 0.7251이 보여주듯 중간 출력을 그대로 복사하지 않는다.
- 최적화는 모델마다 다르게 작동한다 — Llama-3.1-8B는 QUAL·LEAK 동시 개선, Llama-3.2-1B는 QUAL 개선과 LEAK 악화가 동시에 발생한다. 모델별 ablation 없이 단일 지표로 판단하면 안 된다.
- 거짓 양성이 LEAK 불일치의 71.4% — 유출 판정 지표는 보수적으로 설계되어 있어, 낮은 LEAK 점수를 해석할 때 이 편향을 감안해야 한다.
- 비용 상승은 작다 — $0.063 → $0.076, 입력 토큰 −193.9 / 완성 토큰 +136.4.
최종 핵심 정리
확인해 볼 핵심 질문:
- Privacy-Conscious Delegation은 차분 프라이버시와 무엇이 다른가? → 처음부터 비신뢰 모델이 PII에 접근하지 못하게 하는 것
- PUPA는 어디서 왔는가? → WildChat 100만 건 → 901개 상호작용 → 3개 카테고리 재선별 → PUPA-TNB 237턴 / PUPA-New 664턴
- PII 추출의 실제 주 설정은? → LLM 직접 추출이 아니라 레댁션 우선 3단계(레댁션 → 정규식 추출 → 중복 제거)
- 최적 결과는? → Llama-3.1-8B-Instruct + GPT-4o-mini, QUAL 85.5 / LEAK 7.5
- 남은 과제는? → 프로퍼ietary LLM과의 품질 격차, LLM 기반 지표 의존, 이론적 보장 부재
한 줄 요약: PAPILLON은 "강한 모델에 PII를 넘기지 않고도 품질을 85.5까지 유지할 수 있다"를 보여주었고, 남은 숙제는 그 격차를 이론과 지표로 더 단단하게 만드는 일이다.
댓글 0
아직 댓글이 없습니다 — 첫 댓글을 남겨보세요.